관심 있는 NLP 논문을 읽어보고 간단히 정리했습니다.
혹시 부족하거나 잘못된 내용이 있다면 댓글 부탁드립니다 🙇♂️
[Onyx, UC Berkeley]
- Slack, Gmail, Jira, Confluence 등 9개 enterprise source type으로 구성된 약 50만 개 문서의 synthetic corpus와 10개 카테고리 500개 질문으로 이루어진 RAG 벤치마크 EnterpriseRAG-Bench 공개
- human-in-the-loop scaffolding 기반의 generation framework로 cross-document coherence를 유지하면서 misfiled documents, near-duplicates, conflicting info 같은 realistic noise를 주입
- gold label을 고정된 정답이 아니라 three-judge consensus로 갱신되는 revisable hypothesis로 취급하는 correction-aware evaluation framework 제안
- baseline 실험에서 BM25가 vector search를 크게 앞서고, Bash Agent는 completeness에서 가장 높은 점수를 기록
1. Introdcution
RAG가 LLM에게 학습 시점에 없던 정보를 제공하는 표준적인 방식으로 자리 잡으면서 관련 벤치마크도 정말 많이 나왔는데요.
Natural Questions, MS MARCO, BEIR 같은 고전적인 데이터셋부터 HotpotQA, MuSiQue, BrowseComp-Plus 같은 multi-hop 벤치마크, PubMedQA나 FinQA 같은 도메인 특화 벤치마크까지 다양합니다.
그런데 이 벤치마크들은 전부 공통된 가정을 하나 깔고 있습니다.
바로 corpus가 Wikipedia, 포럼, 웹 검색 결과, 논문 같은 공개 출처에서 왔다는 것이죠.
저자들은 오늘날 RAG가 가장 많이 쓰이는 곳 중 하나가 회사 내부 지식(문서, 메시지, 티켓, 레코드)인데도 이를 제대로 반영한 벤치마크가 없다는 점을 지적합니다.
Databricks의 KARLBench 정도가 유사한 시도이긴 한데, 그것도 corpus 대부분이 공개 문서고 proprietary subset은 아주 일부라고 하네요.
회사 내부 데이터는 공개 corpus와 성격이 꽤 다릅니다.
정리가 안 되어 있고, 노이즈가 많고, 지원 티켓이나 이메일 스레드, 고객 통화 기록, 채팅 같은 공개 벤치마크에는 없는 문서 타입이 섞여 있죠.
(회사에서 사내 RAG를 만들어 보신 분들이라면 다들 공감하실 것 같습니다.)
그래서 이 논문에서는 다섯 가지 설계 원칙을 세우고 이를 반영한 synthetic corpus를 만들었습니다.
(1) Cross-document coherence: 문서들이 공유된 initiative, 사람, 의사결정을 통해 서로 연결되어야 하고,
(2) Realistic volume distribution: source type 간 문서 비율과 토픽 분포가 현실을 반영해야 하며,
(3) Realistic noise: 잘못 저장된 문서, near-duplicate, 상충하거나 outdated된 정보가 포함되어야 하고,
(4) Internal terminology: 프로젝트 코드네임, 사내 약어처럼 회사 밖에서는 의미 없는 용어를 써야 하며,
(5) Generality: 특정 도메인에 묶이지 않고 다양한 산업/규모의 기업에 적용 가능해야 한다는 것입니다.
여기에 현실적인 제약도 하나 있습니다.
수십만 개 문서를 LLM으로 생성하는데 매 문서마다 corpus 전체를 참조하게 만들면 비용이 감당이 안 됩니다.
그래서 소규모의 tightly coupled 문서 집합은 high-fidelity로, 대부분의 bulk 문서는 scaffolding-guided로 저렴하게 생성하는 이원화 전략을 취했다고 합니다.
이 부분은 뒤의 Method에서 자세히 다루겠습니다.
2. Dataset Overview
corpus는 "Redwood Inference"라는 가상의 테크 회사를 시뮬레이션합니다.
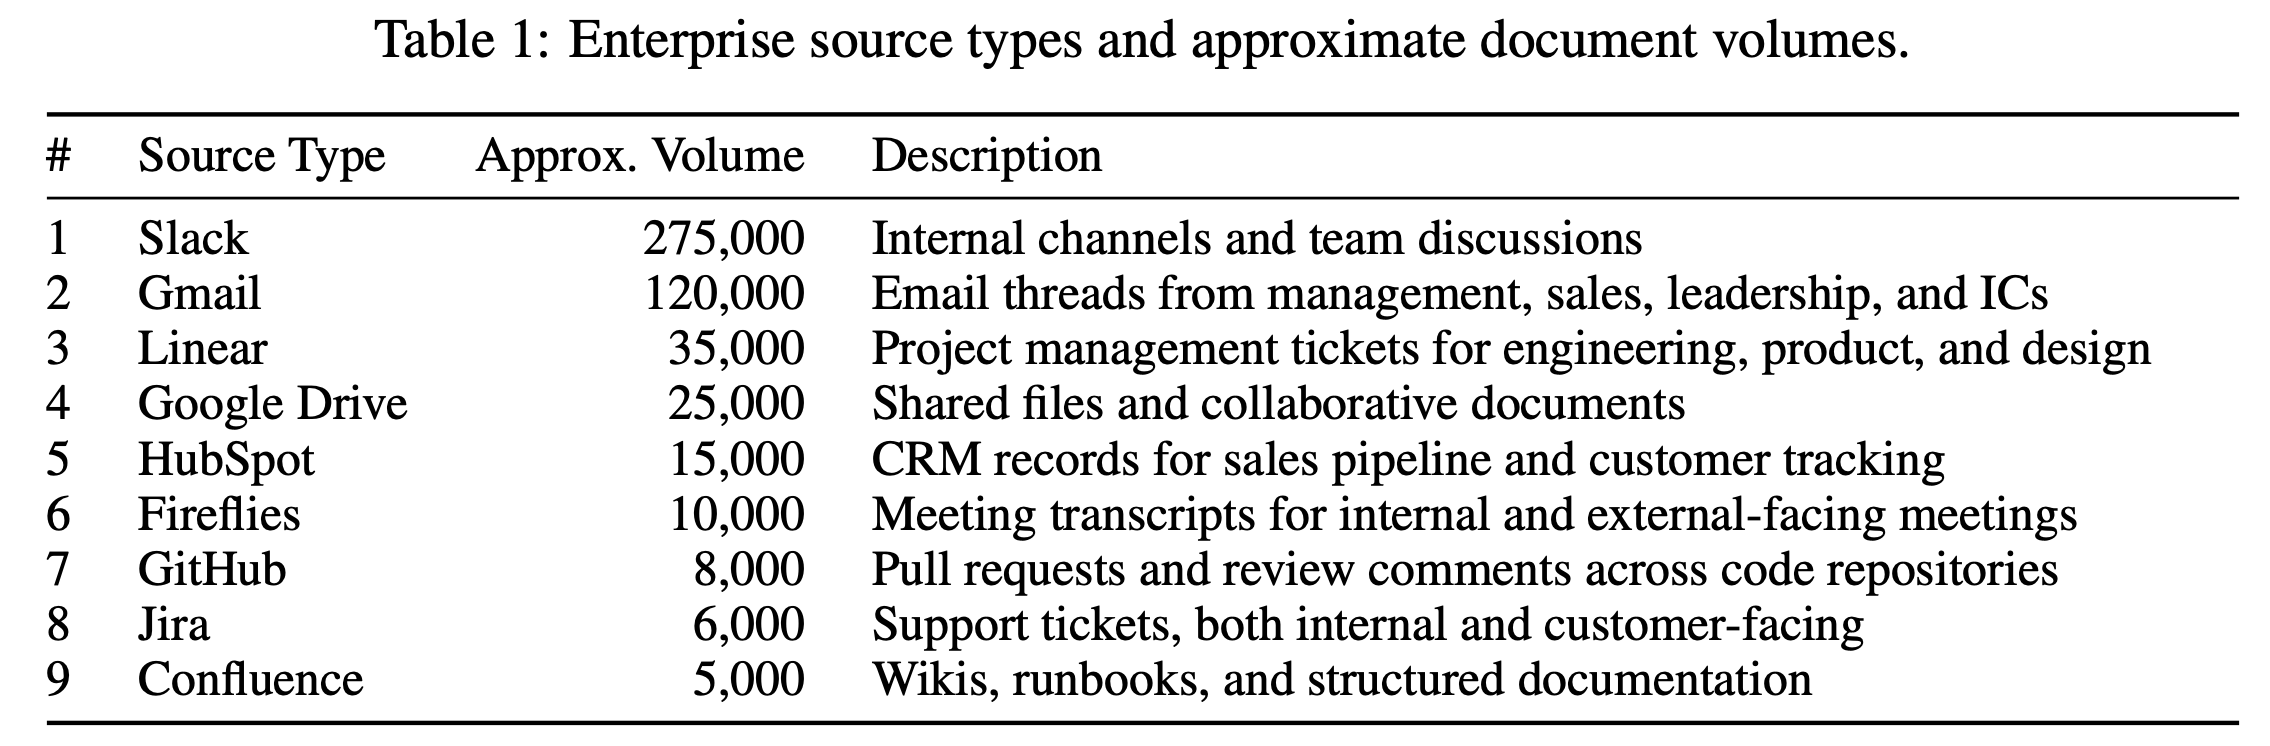
9개 source type의 문서 볼륨인데요.
Slack이 27.5만, Gmail이 12만 개로 압도적이고, Confluence는 5천 개에 불과합니다.
이건 의도된 불균형으로, 비공식적인 커뮤니케이션 채널이 잘 정리된 knowledge base보다 훨씬 많은 문서를 만들어낸다는 현실을 반영한 것입니다.
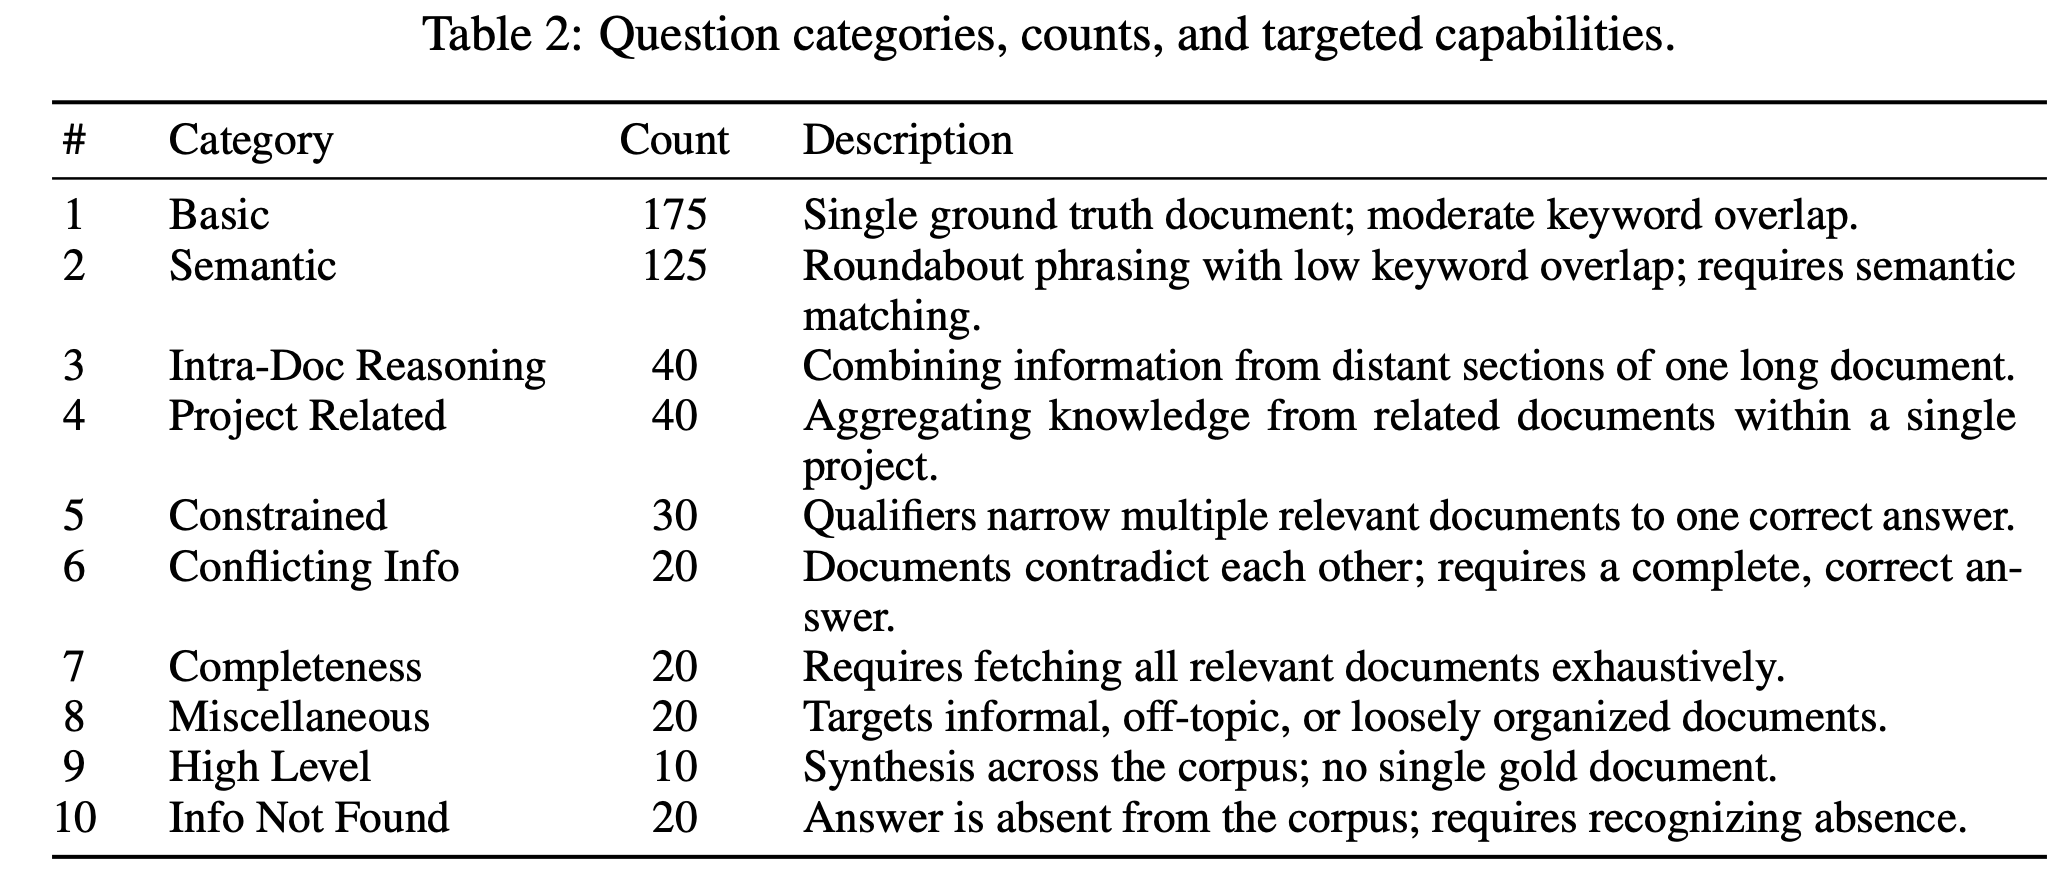
질문은 10개 카테고리, 총 500개입니다.
각 카테고리가 어떤 능력을 테스트하는지 간단히 정리하면 다음과 같습니다.
- Basic (175) / Semantic (125): 단일 gold document를 찾는 기본 검색. Basic은 키워드 overlap이 적당히 있고, Semantic은 일부러 표현을 돌려서 키워드 overlap을 낮춘 질문입니다.
- Intra-Doc Reasoning (40): 하나의 긴 문서 내에서 멀리 떨어진 섹션의 정보를 합쳐야 답할 수 있는 질문입니다. chunk 단위로 embedding하는 시스템의 약점을 노린 것이죠.
- Project Related (40): 같은 initiative에 속한 여러 문서를 종합해야 하는 질문입니다.
- Constrained (30): 비슷해 보이는 문서가 여러 개 있지만, 질문 속 qualifier들이 필터 역할을 해서 정답 문서가 하나로 좁혀지는 질문입니다.
- Conflicting Info (20): 문서끼리 내용이 상충해서 어느 쪽이 최신인지 판단해야 하는 질문입니다.
- Completeness (20): 관련 문서 전부를 빠짐없이 찾아야 하는 질문입니다.
- Miscellaneous (20): slack/memes 같은 비공식적이고 예측하기 어려운 위치에 있는 문서를 대상으로 합니다.
- High Level (10): corpus 전반에 걸친 종합이 필요하고, 단일 gold document가 없습니다.
- Info Not Found (20): corpus에 답이 없어서 "모른다"고 답해야 하는 질문입니다.
개인적으로는 Info Not Found와 Conflicting Info가 들어가 있는 게 마음에 듭니다.
실제 사내 RAG를 운영하면서 가장 골치 아픈 게 "없는 정보를 그럴듯하게 지어내는 것"과 "옛날 문서를 보고 outdated된 답을 하는 것"이니까요.
3. Dataset Analysis
이 섹션에서는 만들어진 synthetic corpus가 실제 기업 데이터와 구조적으로 얼마나 유사한지를 검증합니다.
비교 대상은 두 개인데요, 하나는 논문을 쓴 회사 Onyx의 실제 내부 데이터(벤치마크와 겹치는 source type으로 제한)이고,
다른 하나는 open-domain 대표로 BrowseComp-Plus입니다.
embedding은 모두 OpenAI의 text-embedding-3-large를 사용했습니다.
(이 임베딩 모델이 개발된지 벌써 몇 년이 지났고 오픈소스 모델들도 많은데 굳이 이걸 사용한 게 신기하더라고요)
3.1. A Visual Illustration
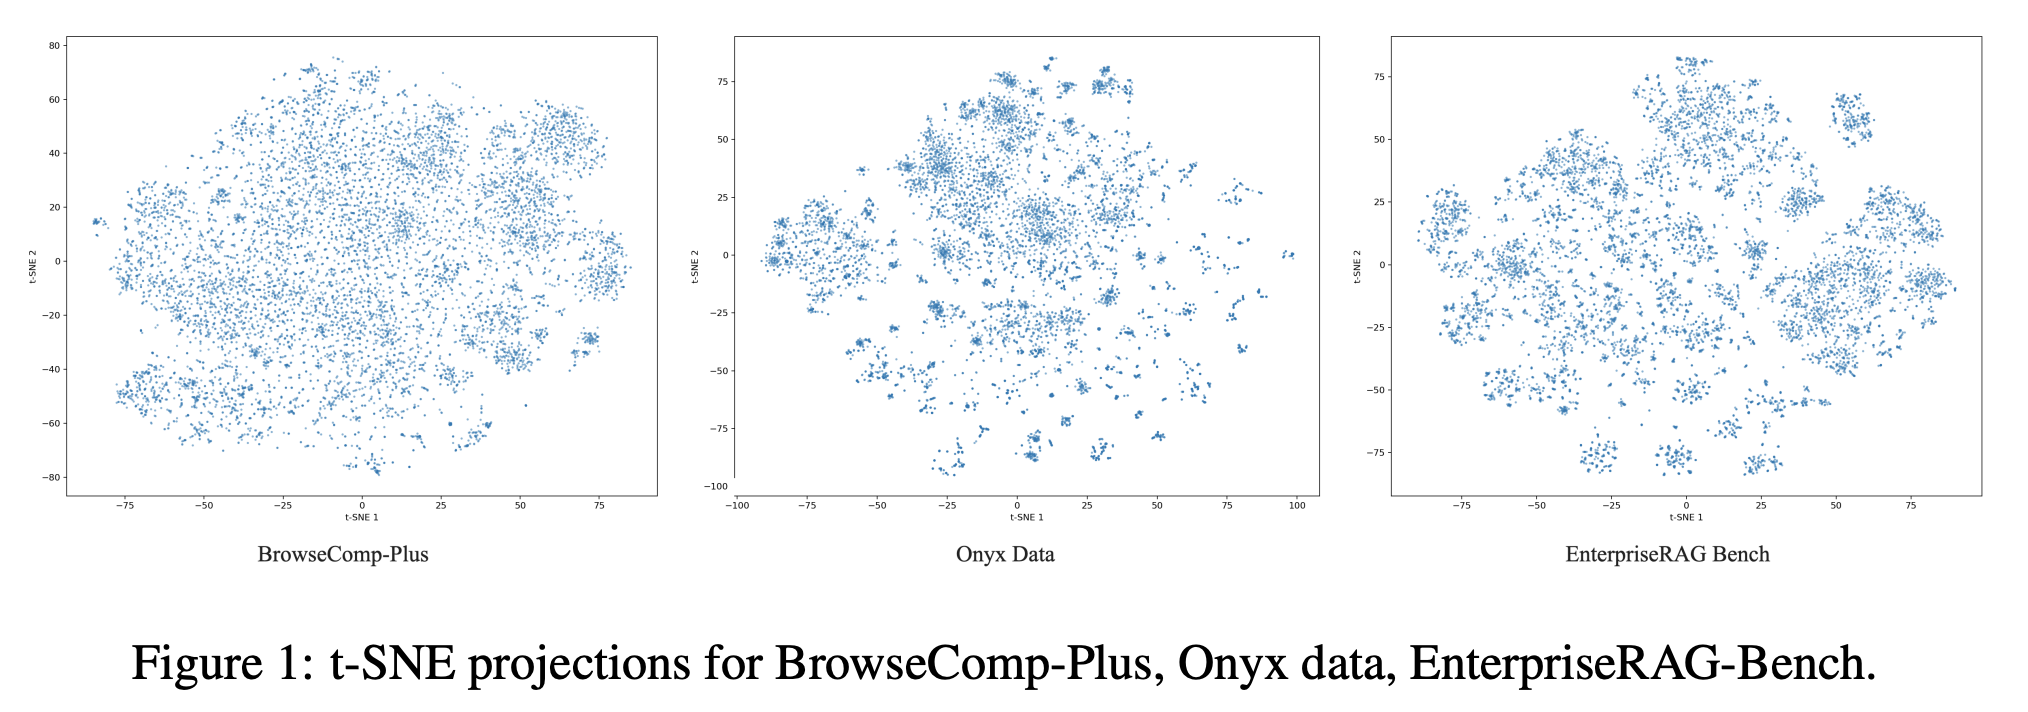
각 데이터셋에서 1만 개 문서 embedding을 샘플링해 t-SNE로 시각화한 결과입니다.
BrowseComp-Plus는 뚜렷한 sub-structure 없이 넓게 퍼진 하나의 구름처럼 보이고, Onyx 데이터는 크기와 밀도가 다양한 cluster로 분해되면서 일부 cluster들이 얇은 bridge로 연결되어 있습니다.
EnterpriseRAG-Bench도 이 clustered structure와 bridging 패턴을 재현하긴 하는데, cluster들의 크기와 밀도가 Onyx보다 좀 더 균일해 보이네요.
저자들은 이걸 topic-based scaffolding 때문이라고 설명합니다.
(t-SNE는 거리를 왜곡하기 때문에 어디까지나 suggestive한 관찰이라는 점도 명시하고 있습니다.)
3.2. Quantitative Analysis
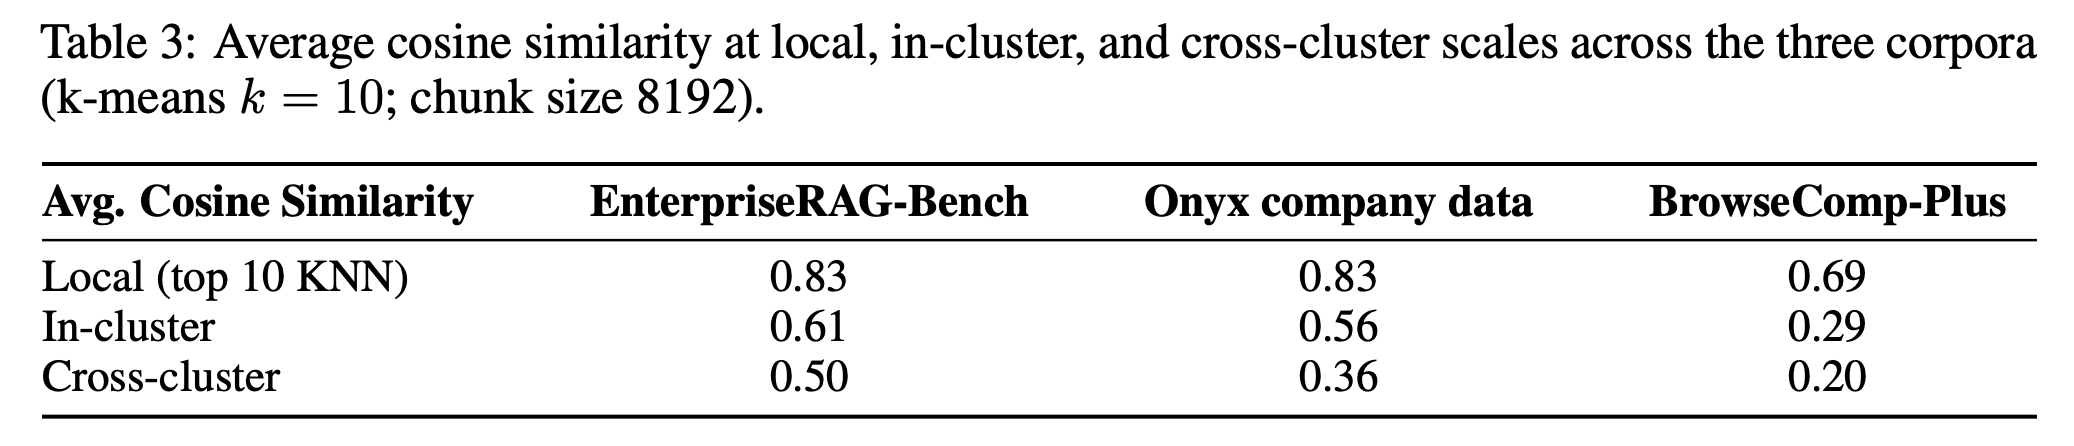
정량 분석은 두 가지 지표로 이루어집니다.
Local density는 각 문서의 top-10 nearest neighbor와의 평균 cosine similarity로,
값이 높을수록 의미적으로 비슷한 distractor가 주변에 많다는 뜻이라 retrieval이 어려워집니다.
Global clustering은 k-means (k=10)로 corpus를 나눈 뒤 같은 cluster 내 문서 쌍의 평균 similarity (in-cluster)와 다른 cluster 간 문서 쌍의 평균 similarity (cross-cluster)를 측정한 것입니다.
결과를 보면 EnterpriseRAG-Bench와 Onyx 데이터는 local similarity가 0.83으로 완전히 동일하고, BrowseComp-Plus의 0.69보다 훨씬 높습니다.
(local similarity가 높아 distractor가 많고 검색하기가 어렵다는 의미로 보입니다)
이게 retrieval 난이도의 핵심 지표라고 저자들은 주장하는데요.
gold document 주변에 비슷한 문서가 잔뜩 있으면 retriever가 넓은 margin에 기댈 수 없으니 당연한 이야기입니다.
다만 in-cluster (0.61 vs 0.56)와 cross-cluster (0.50 vs 0.36) similarity는 벤치마크 쪽이 Onyx보다 높습니다.
저자들은 이를 LLM이 현실적인 peripheral / off-topic 콘텐츠를 잘 못 만들기 때문이라고 해석하고요.
(LLM에게 다양한 주제로 생성하라고 해도 되게 비슷한 복제품 수준의 결과물을 내놓는 상황을 생각해보시면 이해가 쉬울 것 같습니다)
실제 corpus에는 검색 난이도에 기여하지 않으면서 문서 수만 늘리는 잡다한 문서가 많은데, synthetic corpus에는 그런 게 적으니 "raw document count보다 더 큰 corpus처럼 행동한다"는 설명입니다.
설득력은 있는데, 반대로 말하면 "쉽게 버릴 수 있는 문서가 적다"는 건 실제 환경보다 노이즈 필터링 능력을 덜 테스트한다는 의미이기도 해서, 이 부분은 Limitations에서 저자들도 다시 언급합니다.
4. Data Generation Methodology
이 논문의 핵심은 사실 벤치마크 자체보다 generation framework에 있다고 생각합니다.
파이프라인은 문서 집합 생성 → 노이즈 주입 → 질문 생성의 3단계로 구성됩니다.
여기서 두 가지 요구사항이 파이프라인 설계를 결정하는데요.
하나는 corpus가 question-aware여야 한다는 것입니다.
completeness, conflicting info, constrained 같은 질문 타입은 특정한 문서 구조가 corpus에 존재해야 하는데, 이걸 50만 개 문서를 만들고 나서 사후에 찾아내는 건 비현실적이니 의도적으로 만들어 넣어야 한다는 거죠.
다른 하나는 모든 질문이 verifiable ground truth를 가져야 한다는 것입니다.
4.1. Building the Document Set
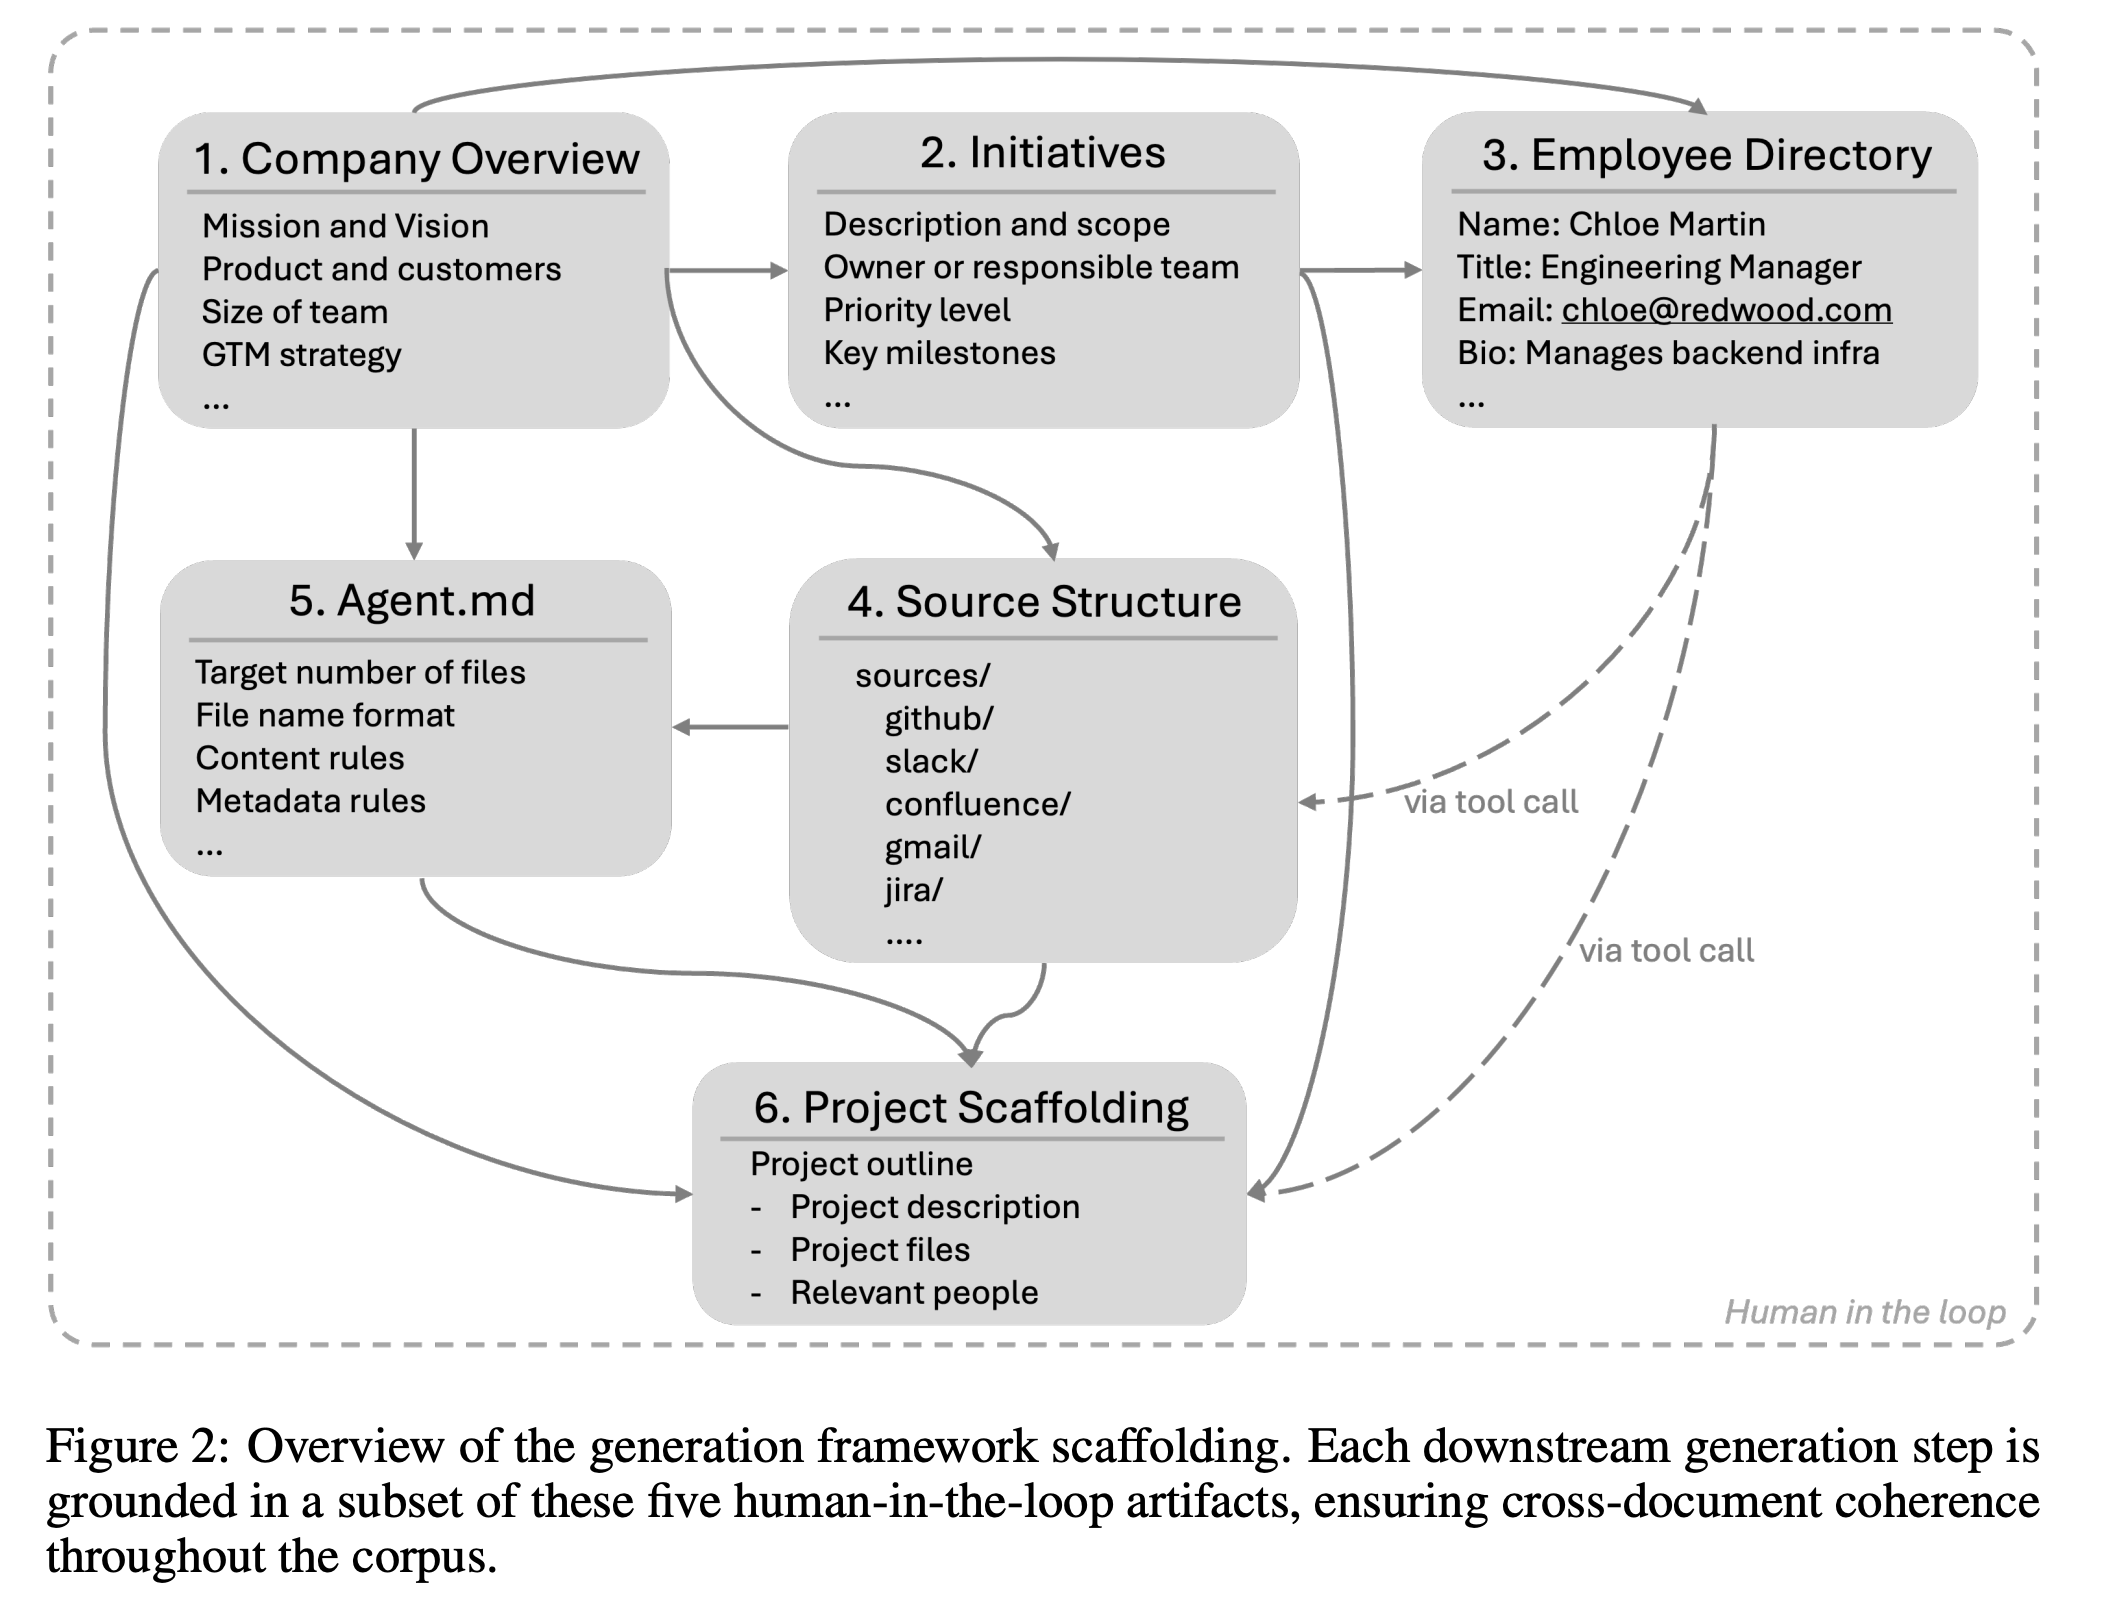
문서 생성은 scaffolding, high-fidelity generation, high-volume generation의 세 단계로 진행됩니다.
Scaffolding
모든 생성은 사람과 LLM이 협업해서 만든 다섯 개의 top-level artifact에서 출발합니다.
(1) 미션, 제품, 기술, 비즈니스 모델, 팀 규모, 펀딩 이력 등을 담은 company overview,
(2) 회사의 주요 전략적 노력을 기술한 high-level initiatives,
(3) 이름, 역할, 부서, 보고 체계가 담긴 employee directory,
(4) 9개 source type 각각의 디렉토리 구조를 정의한 source structure,
(5) 디렉토리 트리 곳곳에 배치되어 해당 위치 문서의 기대 형식과 내용을 자연어로 명시한 agents.md 파일들입니다.
agents.md라는 이름이 재미있는데, 요즘 코딩 에이전트에서 쓰는 관행을 데이터 생성에 그대로 가져온 셈입니다.
예를 들어 "GitHub에는 issue가 아니라 review comment가 달린 pull request만 있다" 같은 규칙을 적어두는 거죠.
initiative는 다시 각각 100개 정도의 문서를 목표로 하는 project로 분해되고, 각 project에는 상세 설명, 문서 manifest, 담당 직원이 배정됩니다.
High-fidelity generation
핵심 문서 집합은 최대한의 cross-document awareness를 가지고 생성됩니다.
각 문서는 company overview, 해당 project의 전체 sibling 문서 manifest, 경로상의 agents.md 파일, 그리고 이미 생성된 project 문서를 필요할 때 읽을 수 있는 read tool에 접근할 수 있습니다.
덕분에 공유된 의사결정, 참조된 회의, 링크된 티켓 같은 실제 기업 지식 특유의 암묵적 cross-reference가 문서에 녹아들게 됩니다.
별도로 completeness cluster라는 것도 만드는데, 4~10개 문서를 서로 완전히 볼 수 있는 상태에서 생성하면서 사실들을 일부러 분산시켜 어느 한 문서도 완전한 답을 담지 않도록 합니다.
High-volume generation
corpus 대부분은 문서당 context를 줄여 비용을 아끼는 파이프라인으로 생성됩니다.
여기서 저자들이 model drift라고 부르는 문제가 등장하는데요.
LLM에 company overview만 주고 문서 100개를 생성시켜 봤더니 LLM judge 기준 40% 이상이 매우 비슷한 sibling을 가지고 있었다고 합니다. (위에서 언급한 그 문제입니다)
모델과 temperature를 바꿔도 정도만 다를 뿐 패턴은 항상 나타났다고 하고요.
(LLM으로 대량의 synthetic data를 만들어 본 분들이라면 이 diversity collapse 문제를 잘 아실 겁니다.)
이를 해결하기 위해 topic scaffolding layer를 도입합니다.
각 source type을 계층적으로 topic과 subtopic으로 분해하고, leaf당 문서 수가 최대 500개가 되도록 재귀적으로 쪼갭니다.
생성 시 모델은 company overview, 핵심 initiative, 관련 agents.md, 그리고 같은 leaf topic 내 다른 문서들의 file path만 봅니다.
이 좁은 context window 덕분에 비용은 크게 줄이면서도 runaway duplication은 없앨 수 있었다고 합니다.
같은 leaf의 file path만 보여주는 것만으로 "겹치지 않는 내용을 쓰라"는 nudge가 된다는 게 꽤 실용적인 트릭이네요.
4.2. Adding Noise
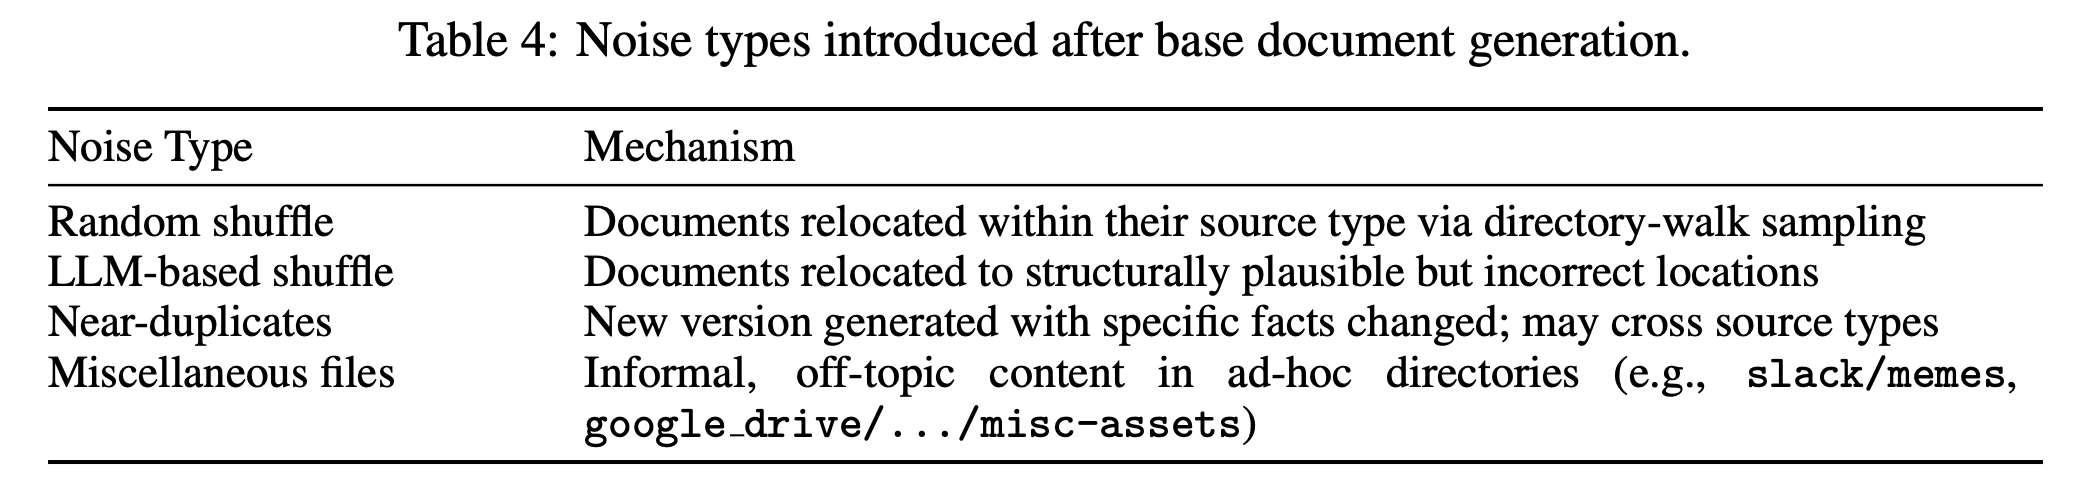
실제 기업 corpus는 깨끗하지 않으니 네 가지 노이즈를 주입합니다.
- Random shuffle은 문서를 같은 source type 내에서 무작위로 다른 위치로 옮기는 것인데, uniform sampling이 아니라 directory walk로 샘플링해서 volume이 큰 source에만 편중되지 않게 합니다.
- source type을 넘나들지 않는 이유는 문서를 rewrite하지 않기 때문입니다. GitHub PR이 Fireflies 통화 기록 디렉토리에 있으면 말이 안 되니까요.
- LLM-based shuffle은 LLM이 디렉토리 계층을 이해한 상태에서 "그럴듯하지만 틀린" 위치(인접 디렉토리, 부모/자식 폴더 등)로 옮기는 방식입니다.
- Appendix에 따르면 random 5%, LLM-based 3%로 총 8%의 문서가 shuffle 영향을 받았습니다.
- Near-duplicates는 특정 사실만 바꾼 새 버전을 생성하는 것으로, 이건 source type을 넘나들 수 있고 (CRM 레코드의 정보가 Slack에서 업데이트되는 식) 나중에 conflicting-info 질문의 재료가 됩니다.
- Miscellaneous files는 slack/memes, google_drive/.../misc-assets 같은 ad-hoc 디렉토리에 비공식적이고 off-topic인 내용을 채워 넣는 것입니다.
4.3. Generating Questions
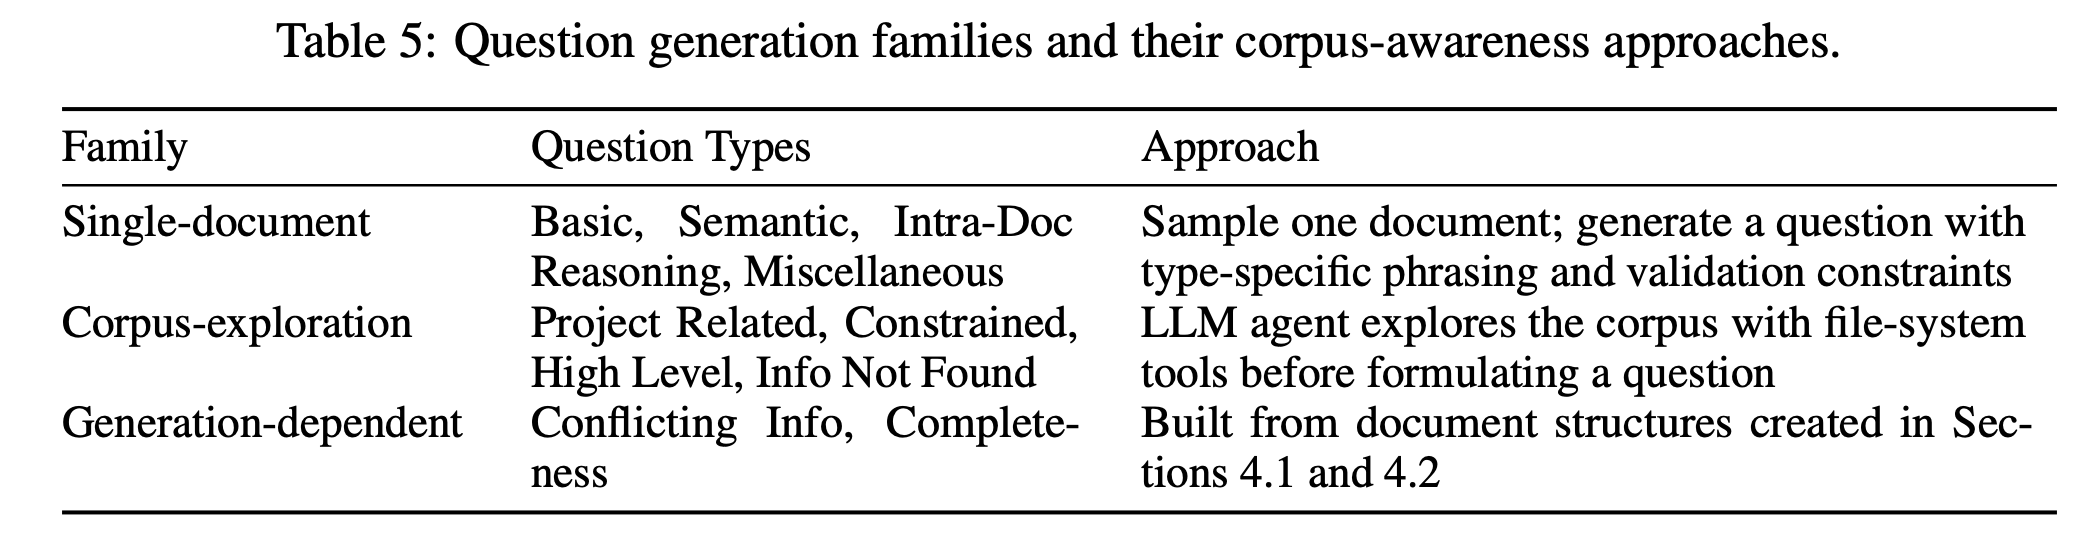
10개 질문 타입은 corpus-awareness 요구사항에 따라 세 family로 나뉩니다.
- Single-document family (Basic, Semantic, Intra-Doc Reasoning, Miscellaneous)는 문서 하나를 샘플링해 질문을 만드는 방식이고, family 내에서는 sampling 기준과 prompt steering만 다릅니다.
- Corpus-exploration family (Project Related, Constrained, High Level, Info Not Found)는 LLM agent에게 glob, grep, read 같은 file-system tool을 주고 corpus를 탐색하게 한 뒤 질문을 만들게 합니다.
- Generation-dependent family (Conflicting Info, Completeness)는 앞 단계에서 만들어진 near-duplicate pair와 completeness cluster를 그대로 활용합니다.
모든 flow는 공통된 출력 구조를 가지는데, 질문, gold answer, fine-grained completeness scoring용 atomic answer facts 리스트, 그리고 (해당되는 경우) gold document identifier입니다.
Constrained 질문은 여기에 추가로 anti-hallucination facts를 만듭니다.
gold 대신 distractor 문서를 검색했을 때 시스템이 저지를 법한 오류를 negative statement로 적어두는 것이죠.
논문의 예시를 빌리자면 "scenario가 externally managed Postgres를 명시하므로, 답변은 Postgres DB가 in-cluster StatefulSet이라고 주장해서는 안 된다" 같은 식입니다.
개인적으로 이 anti-hallucination facts 아이디어가 꽤 좋다고 생각하는데, 단순히 정답을 맞혔는지가 아니라 "틀린 문서에 낚였는지"를 직접 잡아낼 수 있으니까요.
Info Not Found 질문 생성 방식도 흥미롭습니다.
agent가 corpus를 실제로 탐색해서 topical cluster를 읽은 다음, 그 cluster의 주제와 관련 있지만 문서들이 답할 수 없도록 scoping이나 세부 조건을 살짝 비틀어 질문을 만듭니다.
표면적인 키워드 매칭으로는 그럴듯한 문서가 검색되지만, 거기서 도출한 답은 무조건 hallucination이 되도록 설계한 것입니다.
기타 타입별 디테일은 논문 Appendix C에서 직접 확인하실 수 있습니다.
4.4. Quality Assurance
문서로부터 질문을 back-generate한다고 해서 그 문서가 유일한, 혹은 최선의 정답 문서라는 보장은 없습니다.
50만 개 규모에서는 다른 문서가 우연히 더 좋은 답을 담고 있는 collision이 "edge case가 아니라 expected outcome"이라는 게 저자들의 표현인데요.
이를 위해 세 가지 장치를 둡니다.
- LLM-based conformance check는 타입별 요구사항을 검증하는 것으로, 예를 들어 intra-doc reasoning 질문이 단일 contiguous passage로 답할 수 없는지, high-level 질문이 단일 문서로 답할 수 없는지 등을 확인해서 실패하면 재생성하거나 버립니다.
- Multi-retriever pooling은 BM25, vector search, bash agent 세 가지 독립적인 retrieval 시스템을 질문 집합에 돌려서, 검색된 문서를 원래 gold set과 합친 뒤 three-judge consensus로 누락된 gold document를 찾거나 잘못된 것을 flag하는 것입니다.
- 모든 수정이 회복 가능한 건 아니어서, 예를 들어 정확히 하나의 gold document만 가져야 하는 타입에서 두 번째 gold document가 발견되면 그 질문은 버려야 합니다.
- 그래서 각 타입을 목표치보다 넉넉히 생성해두고 수정이 필요했던 질문은 버린 뒤 남은 것에서 랜덤 샘플링하는 방식을 취했습니다.
- Ongoing human curation은 leaderboard 제출을 받으면서 참가 시스템이 찾아낸 gold document 및 answer 수정 사항을 모아 주기적으로 데이터셋에 반영하겠다는 것입니다.
5. Evaluation Framework
5.1. Metrics
각 질문은 네 가지 차원에서 채점됩니다.
- Correctness는 후보 답변이 gold answer와 대체로 일치하는지에 대한 binary LLM judgment입니다.
- 문체 차이나 추가 정보에는 관대하지만 factual conflict나 수치 불일치가 있으면 안 됩니다.
- Completeness는 gold의 atomic answer facts 중 후보 답변이 지지하는 비율입니다.
- 각 fact를 독립적으로 LLM judge가 검증하기 때문에 하나의 판단 오류가 다른 것에 전파되지 않습니다.
- Document Recall은 gold document 중 검색된 집합에 포함된 비율로, 기본적으로 Recall@10입니다.
- Invalid Extra Documents는 gold set에도 없고 judge가 "valid" (관련은 있지만 필수는 아님)로 분류하지도 않은 검색 문서의 개수입니다.
비율이 아니라 절대 개수를 보고하는 이유는, answer generator가 영향을 받는 건 불필요한 내용의 비율이 아니라 양이기 때문이라고 하네요.
Correctness와 completeness 판단은 서로 독립적으로 이루어지고, 채점 전에 citation은 제거해서 judge가 reference formatting에 영향받지 않도록 합니다.
Leaderboard 점수는 다음처럼 계산됩니다.
$$\text{Score} = \frac{1}{N} \sum_{i=1}^{N} \mathbb{1}[\text{correct}_i] \cdot \text{completeness}_i$$
$N$은 전체 질문 수, $\mathbb{1}[\text{correct}_i]$는 $i$번째 질문의 답변이 correct로 판정되면 1, 아니면 0인 indicator, $\text{completeness}_i$는 해당 질문에서 지지된 atomic fact의 비율입니다.
위 내용을 풀어서 생각해보자면, 답이 틀리면 아무리 많은 fact를 맞혔어도 0점이고, 답이 맞으면 얼마나 빠짐없이 답했는지에 따라 부분 점수를 받는 구조입니다.
(수식 자체는 논문에 없고 설명을 제가 수식으로 옮긴 것입니다.)
5.2. Comparative Evaluation
두 시스템을 head-to-head로 비교하는 모드도 지원합니다.
양쪽의 검색 문서를 합쳐 three-judge correction을 거친 뒤 동일한 (갱신되었을 수 있는) gold set으로 채점하고, 별도의 three-judge panel이 질문별 선호를 매깁니다.
positional bias를 줄이기 위해 순서를 무작위로 바꾸고, 검색 문서를 shared / system-unique subset으로 나누어 어디서 차이가 나는지 분석할 수 있게 했습니다.
5.3. Gold Set Correction
이 벤치마크의 핵심 설계 결정 중 하나는 gold set이 static이 아니라는 점입니다.
시스템이 gold set과 다른 문서를 검색해 오면, evaluation pipeline이 gold label을 갱신해야 하는지 먼저 판단합니다.
gold document와 후보 검색 문서의 합집합을 세 명의 독립적인 LLM judge가 각각 "required" (답변에 필수), "valid" (관련 있지만 필수는 아님), "invalid" (도움 안 됨)로 분류합니다.
Ordinal majority vote로 최종 분류가 정해지는데 tie-breaking은 gold-biased입니다.
즉, 기존 gold document는 과반이 "invalid"라고 하지 않는 한 "required"로 유지되고, 후보 문서는 strict majority가 있어야 승격됩니다.
"valid" 문서는 gold set에 들어가지 않지만 invalid extra document로 감점되지도 않습니다.
near-duplicate나 corroborating source가 invalid count를 부풀리는 걸 막기 위한 장치죠.
required set이 바뀌면 gold answer와 answer facts도 갱신된 문서로부터 재생성되는데, anti-hallucination facts는 원래 것을 보존합니다.
한 가지 주의할 점은, leaderboard 제출은 모두 초기 release에 포함된 동일한 고정 gold set으로 채점된다는 것입니다.
수정 사항은 offline으로 누적되어 다음 versioned release에 반영되고, 같은 버전 내에서 소급 rescoring은 하지 않습니다.
공정한 비교를 위해서는 당연한 선택인데, 그러면 "correction-aware"라는 게 leaderboard 관점에서는 실질적으로 다음 버전을 위한 데이터 수집에 가깝다는 점은 인지하고 있어야 할 것 같습니다.
6. Experiments
6.1. Baseline Systems Performance
세 가지 retrieval configuration을 baseline으로 평가합니다.
BM25는 OpenSearch에서 표준 analyzer로 단일 텍스트 필드에 대해 검색하고, Vector search는 text-embedding-3-large (3072차원)로 embedding해 Qdrant에서 cosine similarity로 검색합니다.
둘 다 질문당 top-10 문서를 고정으로 가져옵니다.
Bash Agent는 요즘 산업계에서 채택이 늘고 있는 agentic keyword search 패러다임을 대표하는데, grep, find, head 같은 shell tool로 corpus 디렉토리를 10분 제한 안에서 반복 탐색하며 가변 개수의 문서를 선택합니다.
답변 생성과 평가는 모두 GPT-5.4 (Medium Reasoning)를 사용했습니다.
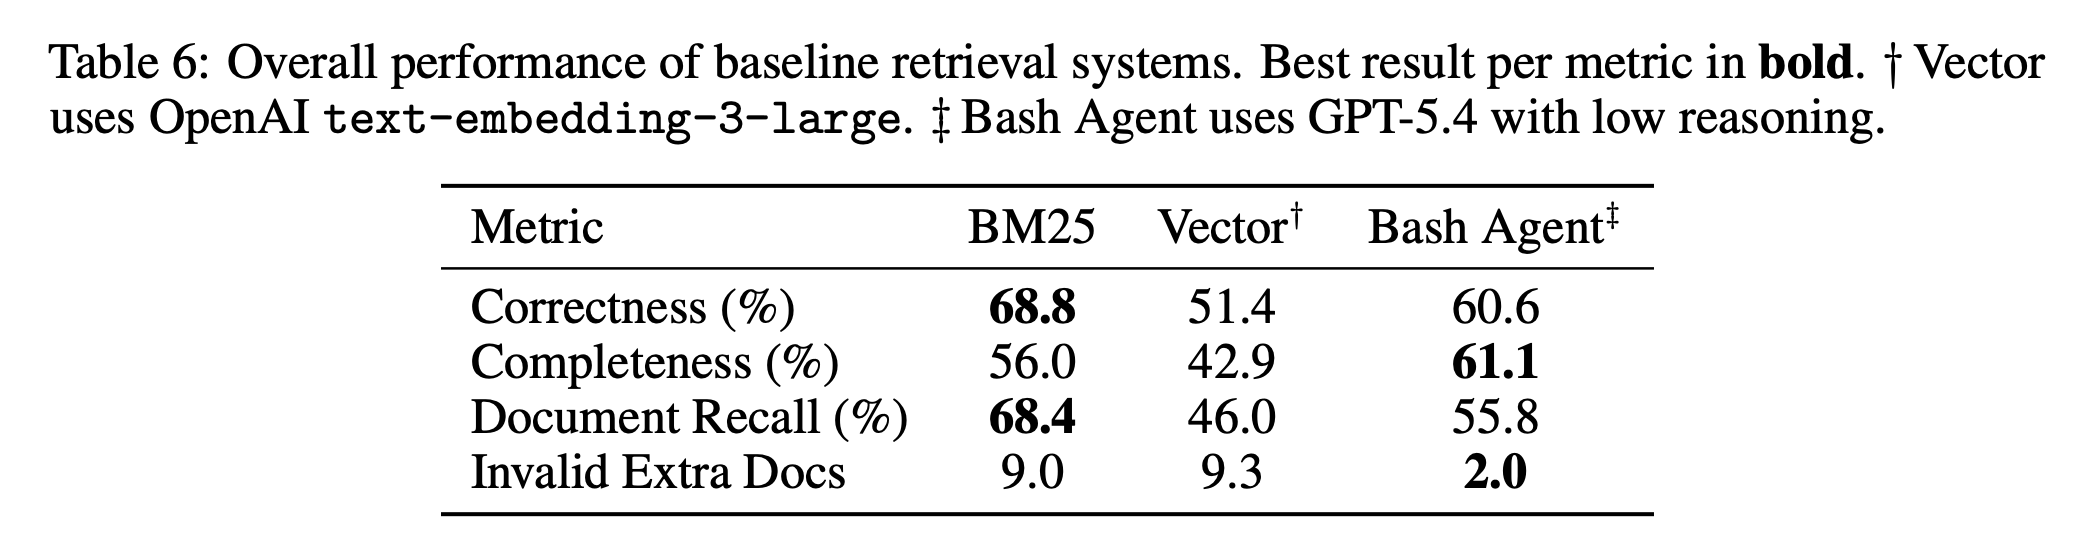
결과가 꽤 흥미로운데요.
BM25가 correctness 68.8%, document recall 68.4%로 1위입니다.
Vector search는 correctness 51.4%, recall 46.0%로 기대 이하였고, 특히 키워드 overlap을 일부러 줄여서 embedding 기반 검색에 유리하게 설계된 Semantic 카테고리에서조차 32.8% correctness, 24.8% recall로 BM25 (44.8% / 43.2%)에 밀렸습니다.
저자들은 두 가지 원인을 추정합니다.
- 하나는 embedding model이 공개 corpus (웹, Wikipedia, 포럼)로 학습되어 프로젝트 코드네임, 사내 약어, 티켓/CRM 같은 structured format, 사내 메시징 특유의 대화 스타일에 노출이 적다는 것이고요.
- 다른 하나는 vector retrieval이 특정 문서를 정확히 찍어내는 targeted lookup보다는 관련 문서들을 넓게 훑는 broad exploration에 더 적합할 수 있다는 것입니다.
실제로 High Level 질문에서는 vector가 BM25보다 높긴 한데 (60.0 vs 50.0), 질문이 10개밖에 안 돼서 큰 의미를 부여하긴 어렵다고 스스로도 인정하고 있습니다.
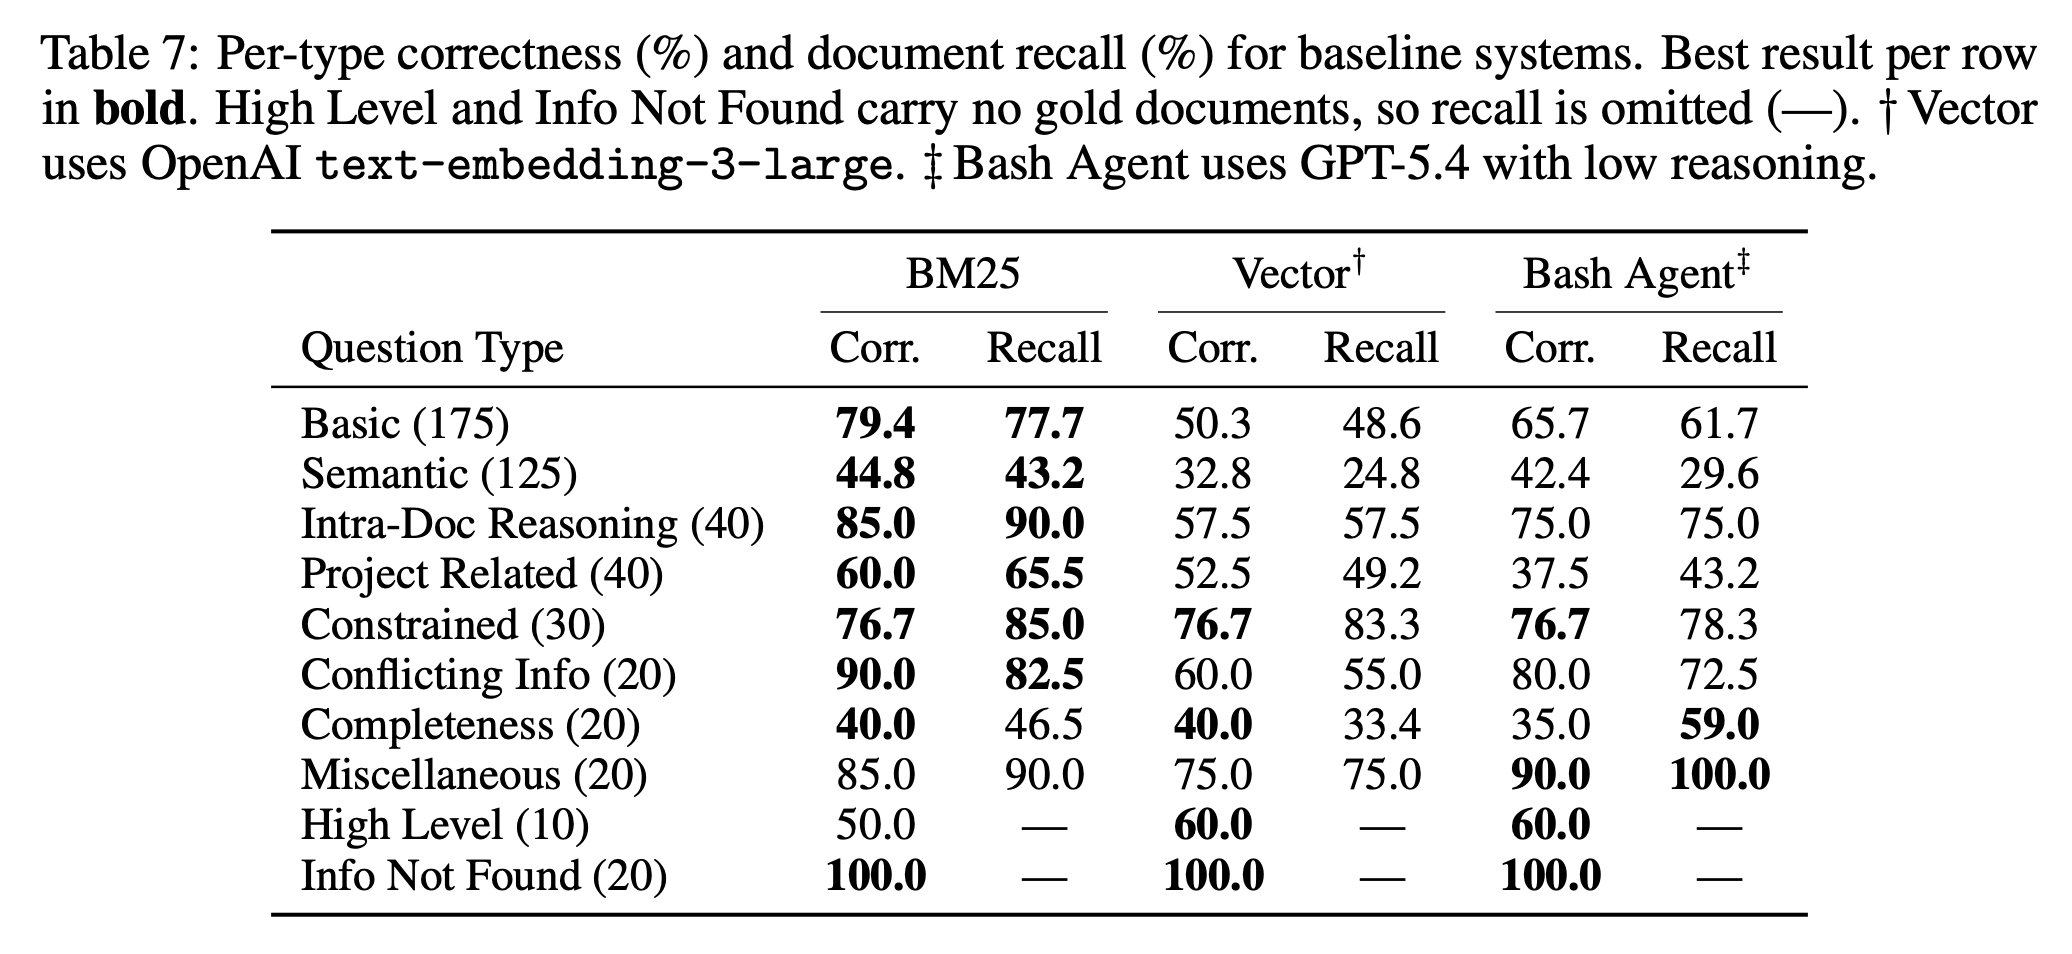
카테고리별 분해를 보면 각 시스템의 성격이 드러납니다.
Bash Agent는 전체 correctness (60.6%)와 recall (55.8%)에서는 BM25에 뒤지지만, completeness 61.1%로 유일하게 60%를 넘겼습니다.
관련 문서를 하나 찾으면 근처 파일과 비슷한 패턴을 따라가며 관련 문서를 더 찾아내는 iterative discovery가 강점인 거죠.
가장 어려운 카테고리인 Completeness에서 recall 59.0% (BM25 46.5%, vector 33.4%)를 기록했고, Miscellaneous에서는 recall 100%로 dense topic 밖에 있는 문서를 찾는 데 특히 강했습니다.
다만 질문당 최대 10분이 걸리고 LLM 비용도 상당해서, BM25나 vector search의 1초 미만 검색과는 비교가 안 되는 latency 비용을 치릅니다.
한편 Info Not Found는 세 시스템 모두 100%인데, 이건 GPT-5.4가 답변 생성을 맡았기 때문에 retrieval보다는 generator의 abstention 능력이 반영된 결과로 보입니다.
retrieval 벤치마크 관점에서는 변별력이 없는 카테고리가 되어버린 셈이라, 좀 더 어렵게 만들 여지가 있지 않나 싶습니다.
BM25 vs vector 결과 자체는 저는 그렇게 놀랍지 않았습니다.
사내 문서처럼 고유명사와 코드네임이 검색의 핵심인 환경에서 lexical matching이 강한 건 실무에서도 자주 관찰되는 현상이니까요.
다만 hybrid search나 reranker를 붙인 baseline이 없다는 점은 아쉽습니다.
실제 production RAG 시스템은 대부분 hybrid를 쓰기 때문에, BM25 + vector + reranker 정도는 baseline에 있었으면 훨씬 참고할 만했을 것 같습니다.
6.2. Scaling Behavior
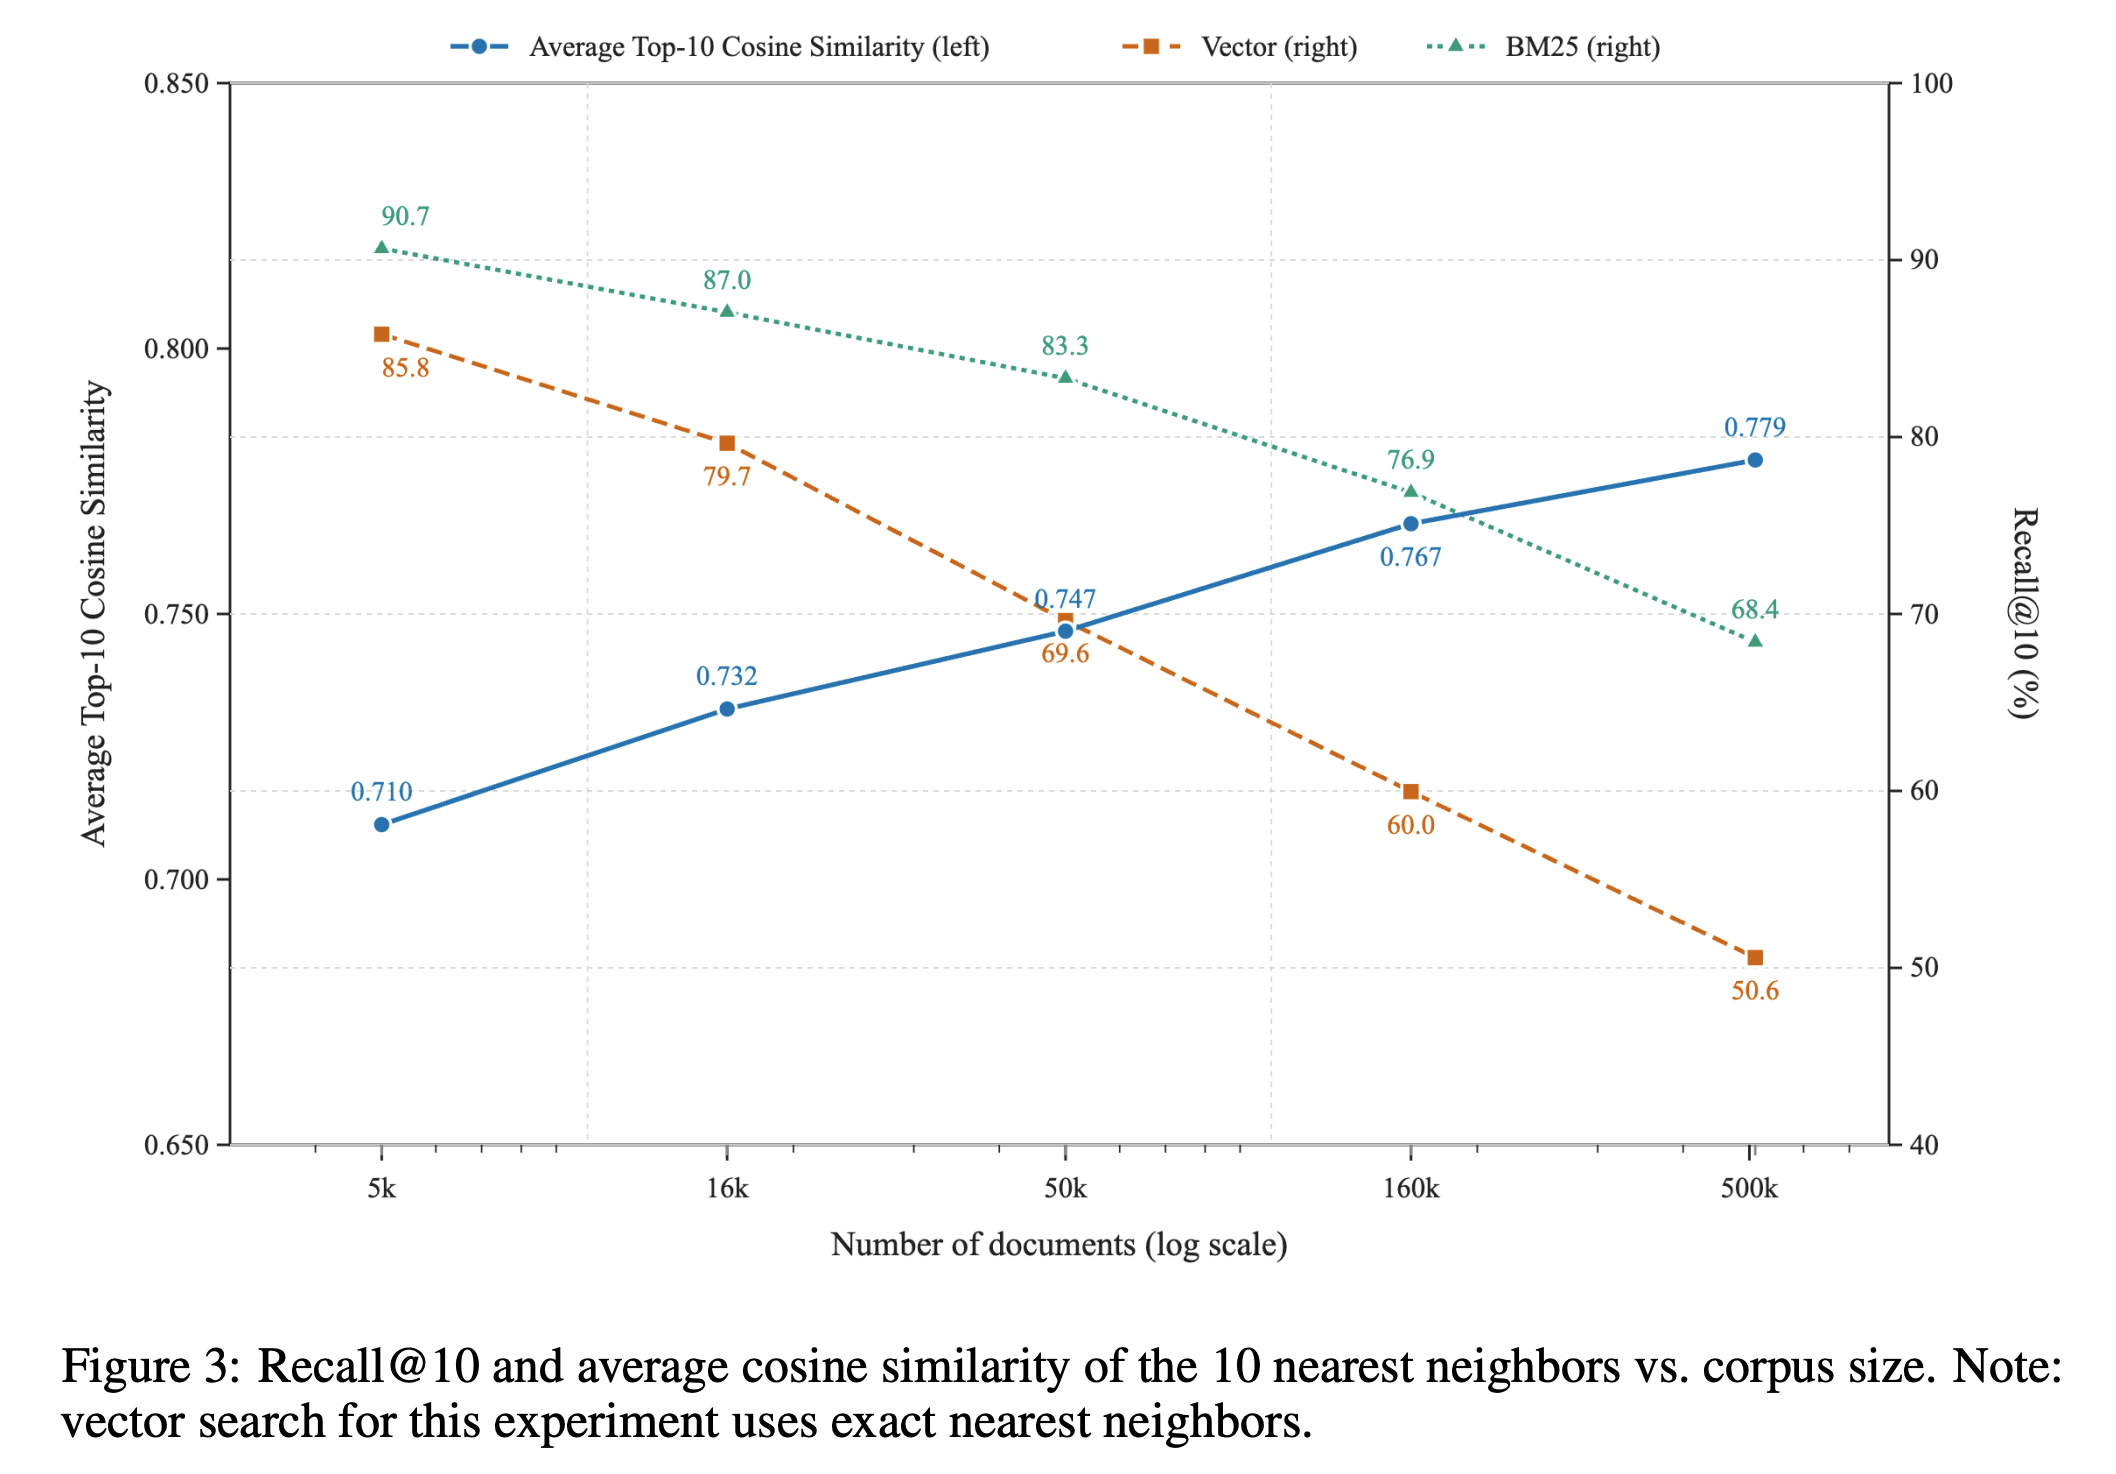
corpus 크기를 5천, 1.6만, 5만, 16만, 그리고 전체 51만 개로 늘려가며 retrieval 성능 변화를 봤습니다.
예상대로 corpus가 커질수록 top-10 local cosine similarity는 0.710에서 0.779로 올라가고, Recall@10은 BM25가 90.7%에서 68.4%로, vector가 85.8%에서 50.6%로 떨어집니다.
vector search의 하락 폭이 더 가파른 게 눈에 띄는데, 문서가 많아질수록 embedding 공간에서 distractor가 촘촘해지는 영향을 더 크게 받는다는 걸 보여줍니다.
소규모 corpus에서 검증한 RAG 시스템이 실제 기업 규모에서는 다르게 동작할 수 있다는 점에서, per-source slice를 따로 배포하는 것도 이런 scaling 실험을 염두에 둔 것으로 보입니다.
7. Limitation
저자들이 스스로 밝힌 한계를 짚어보면 대부분 synthetic data의 근본적인 한계에서 옵니다.
Generation fidelity 측면에서는 네 가지를 언급합니다.
- 파일명에 control character가 들어가는 등의 long-tail error
- Unix timestamp가 123456789 같은 round number로 수렴하거나 회사명이 "ACME"로 기본 설정되는 synthetic randomness artifact
- agents.md 지침에도 불구하고 발생하는 document structure / path drift
- LLM이 만든 대화가 지나치게 focused되어 실제 Slack 스레드의 off-topic tangent나 오해, 잡담을 재현하지 못한다는 점입니다.
마지막 항목은 앞서 3.2절에서 본 in-cluster similarity가 높은 현상과 직접 연결됩니다.
Design tradeoff로는
- high-volume 문서가 employee directory에 접근하지 않아 조직도에 없는 가상 인물을 참조한다는 점
- 단일 테크 회사의 특정 단계만 시뮬레이션한다는 점
- 그리고 현재 규모 이상으로는 stress-test되지 않았다는 점을 듭니다.
그리고 Evaluation 측면에서는 50만 개 규모에서 exhaustive annotation이 불가능하므로 gold label이 언제나 불완전할 수 있다는 점을 다시 강조합니다.
솔직하게 잘 적어둔 Limitations라고 생각합니다.
특히 "LLM이 만든 대화는 비현실적으로 집중되어 있다"는 지적은 synthetic enterprise data를 만들어 보려는 분들이라면 꼭 참고할 만한 관찰입니다.
8. Conclusion and Discussion
이 논문은 회사 내부 지식을 대상으로 한 RAG 벤치마크인 EnterpriseRAG-Bench를 제안합니다.
9개 source type의 50만 개 문서 synthetic corpus, 10개 카테고리 500개 질문, correction-aware evaluation framework, 그리고 다른 산업이나 규모의 회사에 맞춰 변형본을 만들 수 있는 generation framework를 함께 공개했고요.
향후 과제로는 multi-modal retrieval, true multi-hop reasoning, high-volume aggregation, recency-aware retrieval, people-centric question 등을 꼽고 있습니다.
전체적으로 저는 이 논문의 가치가 벤치마크 수치보다는 "기업 내부 데이터를 흉내 내는 방법론"을 꽤 상세하게 공개했다는 데 있다고 생각합니다.
- human-in-the-loop scaffolding, agents.md로 디렉토리별 규칙을 명시하는 것
- topic scaffolding으로 model drift를 막는 것
- question-aware하게 completeness cluster나 near-duplicate pair를 미리 심어두는 것
등은 데이터셋 자체를 쓰지 않더라도 사내 평가 데이터를 만들 때 바로 참고할 수 있는 내용입니다.
Onyx가 enterprise search 제품을 만드는 회사라는 걸 감안하면, 자사 데이터를 직접 공개할 수 없으니 그 구조를 재현하는 프레임워크를 공개한 건 현명한 선택이었던 것 같고요.
아쉬운 점도 몇 가지 있습니다.
첫째, 앞서 언급했듯 baseline이 너무 단순합니다.
hybrid search, reranker, query rewriting 같은 표준적인 기법이 하나도 없어서 "BM25가 vector를 이긴다"는 결론이 실무자에게 주는 정보량이 생각보다 적습니다.
둘째, gold label 수정을 위한 three-judge consensus가 결국 LLM judge에 의존한다는 점입니다.
"LLM이 만든 corpus에서 LLM이 만든 질문을 LLM judge가 채점하고 LLM judge가 gold를 수정한다"는 구조인데, 이 루프 안에서 systematic bias가 있어도 잡아낼 사람이 없다는 게 마음에 걸립니다.
ongoing human curation을 언급하긴 했지만 구체적인 프로세스는 아직 없어 보이고요.
셋째, 현실성 검증이 Onyx 한 회사 데이터와의 embedding 통계 비교에 그친다는 점입니다.
논문에서도 다른 기업 데이터셋으로 확장하겠다고 하니 후속 결과가 궁금해집니다.
그럼에도 사내 RAG를 개발하는 입장에서 공개된 도구 중에 이만한 것이 없었던 것도 사실입니다.
generation framework로 자기 회사 도메인에 맞는 변형본을 만들어 보는 것만으로도 꽤 의미 있는 실험이 될 것 같고요.