[Princeton Univ., UC San Diego, Stanford Univ., USC, JHU] - agent skill이 언제 도움이 되고, 왜 작동하고, 어디서 실패하는지를 controlled experiment + paired trajectory analysis로 분석 - 동일한 trajectory로 만든 Workflow Memory 대비 Skill이 6.06 point 높은 성공률을 기록. skill은 지식을 주입(knowledge injection, 4.5%)하는 게 아니라 행동을 고정(procedural anchoring, 65.7%)하는 방식으로 작동 - skill pool이 5개에서 100개로 커지면 실제 사용 precision은 29.6% → 3.3%로 급락하지만 downstream 성공률은 거의 변하지 않음. 즉 정답 skill 호출은 성공의 필요조건도 충분조건도 아님
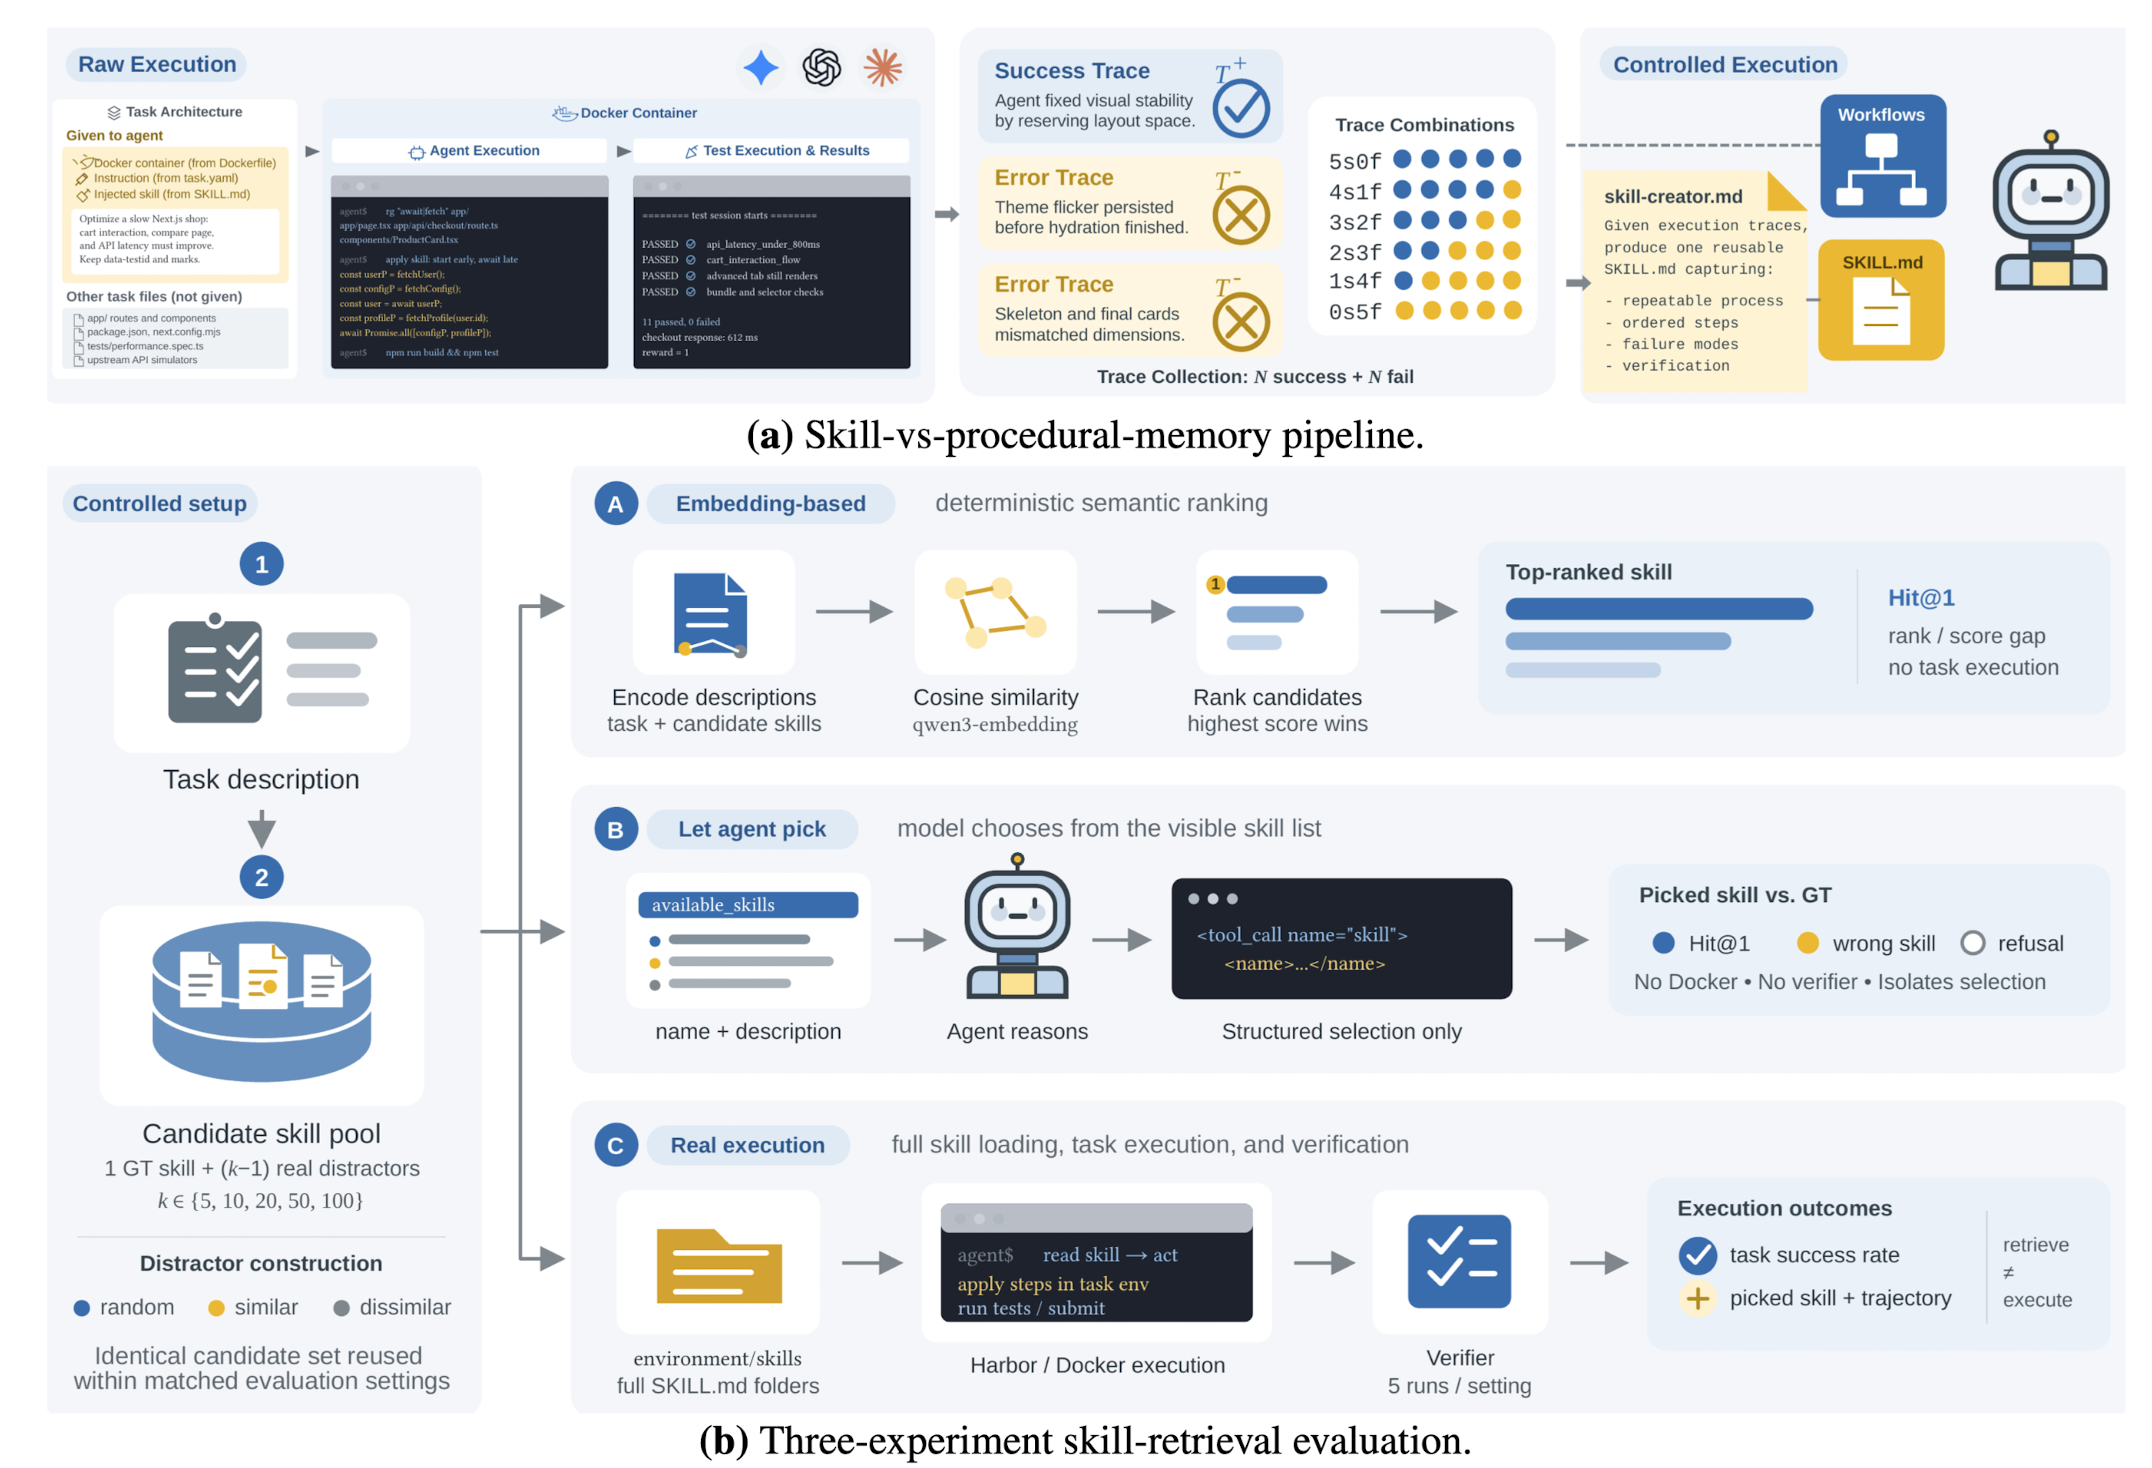
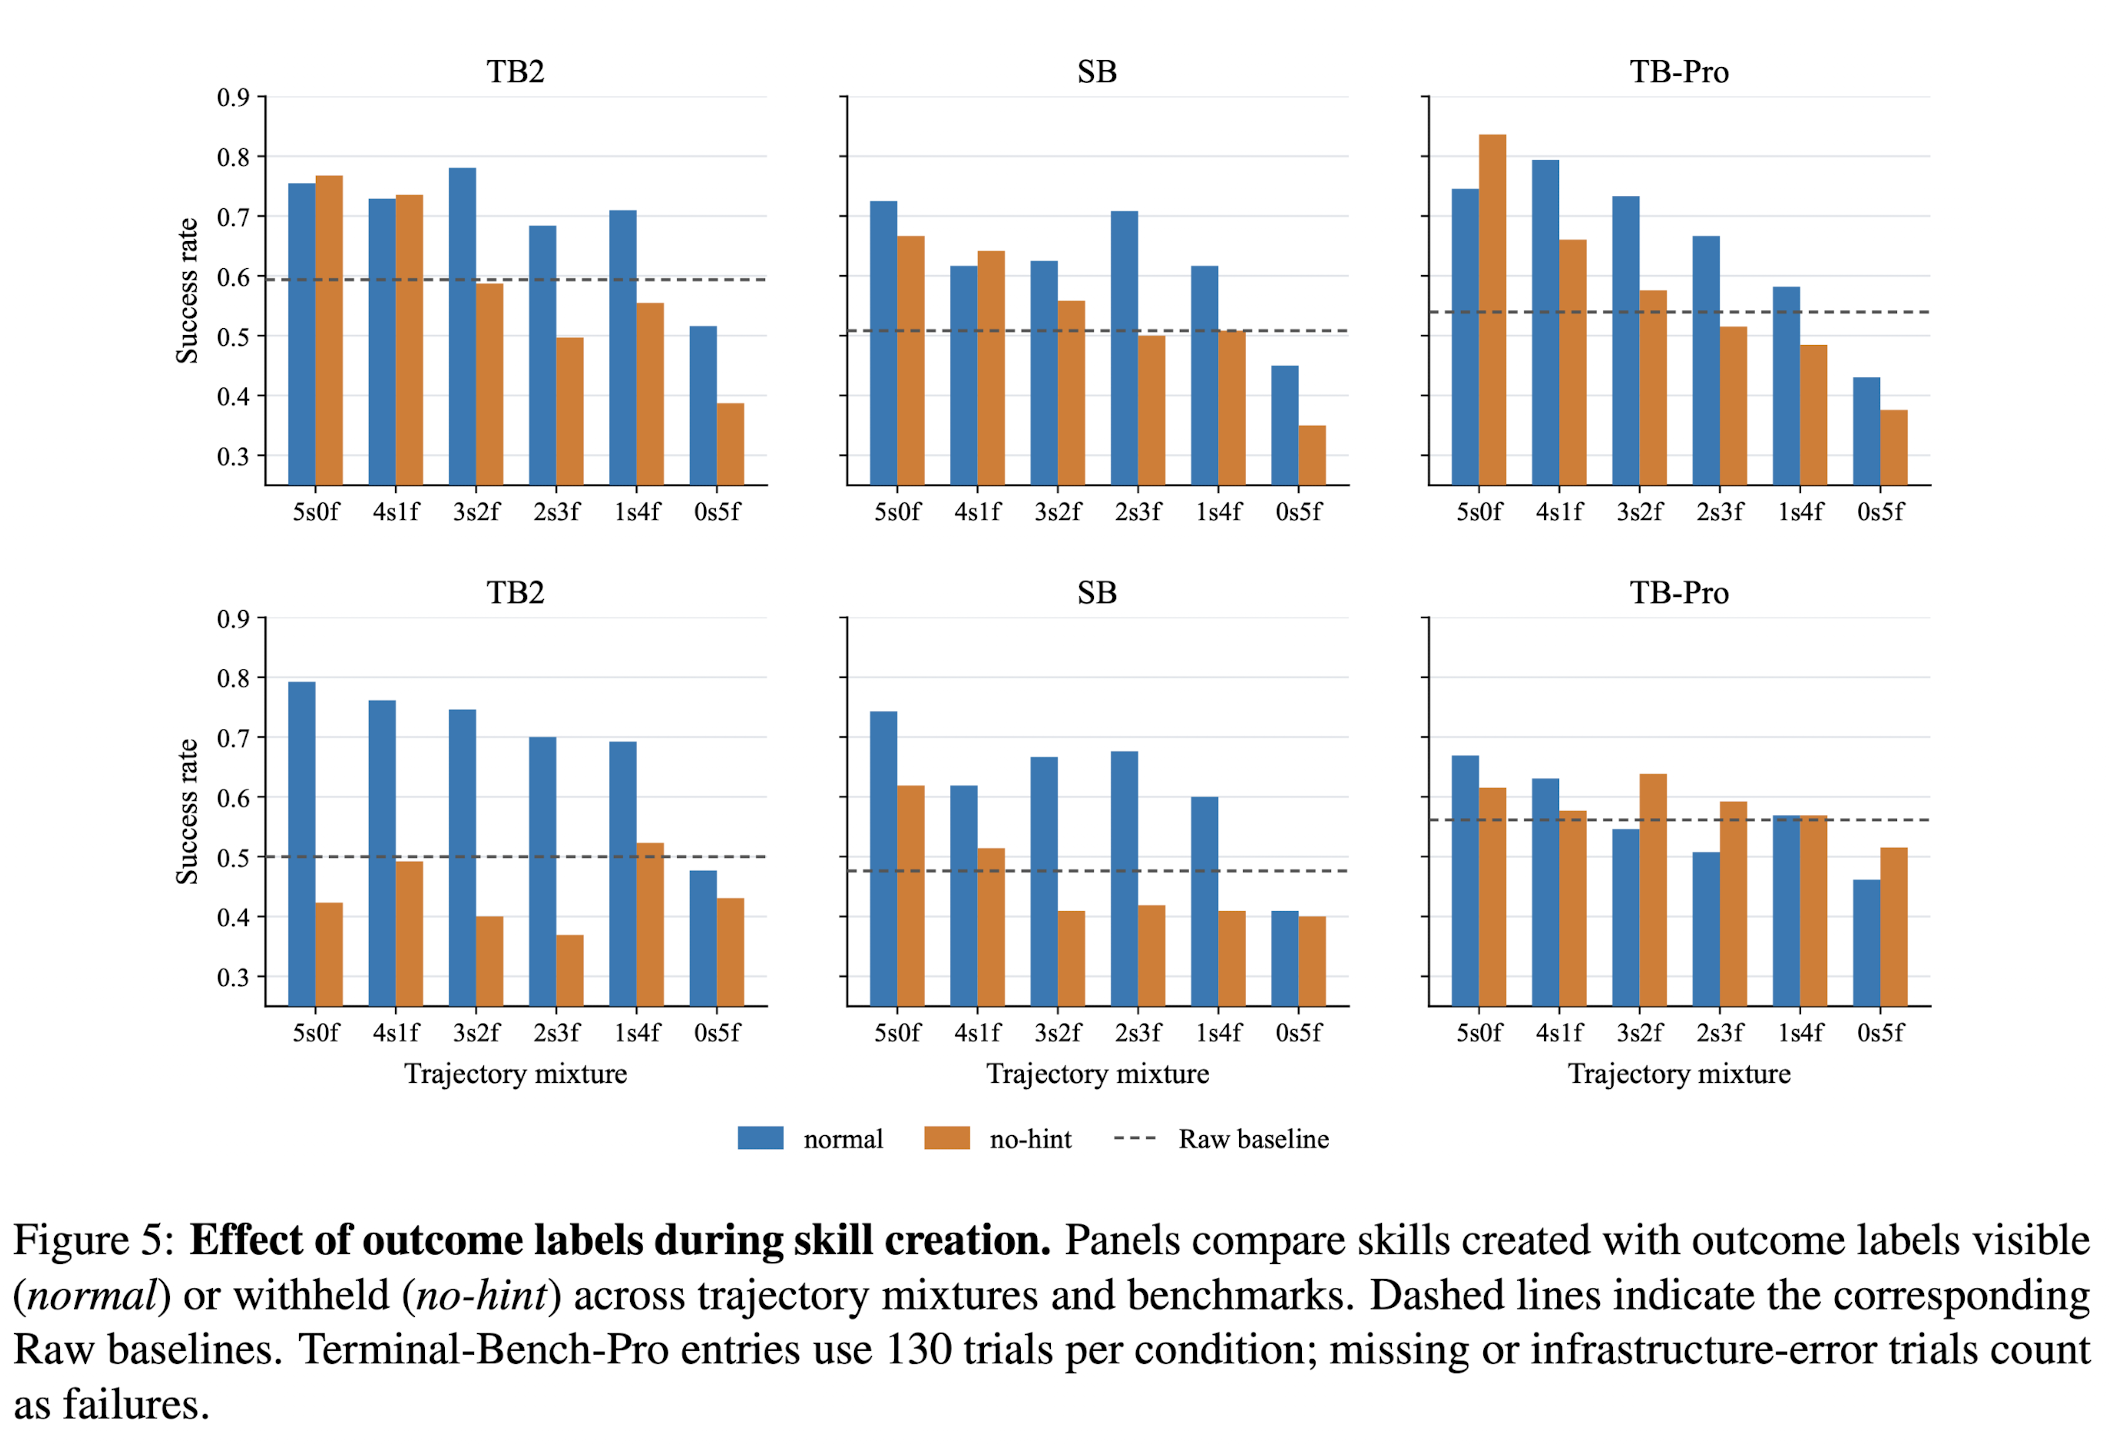
- RQ2를 위해서는 skill-creator에게 성공/실패 label을 알려주지 않는 no-hint 변형을 만들었고요.
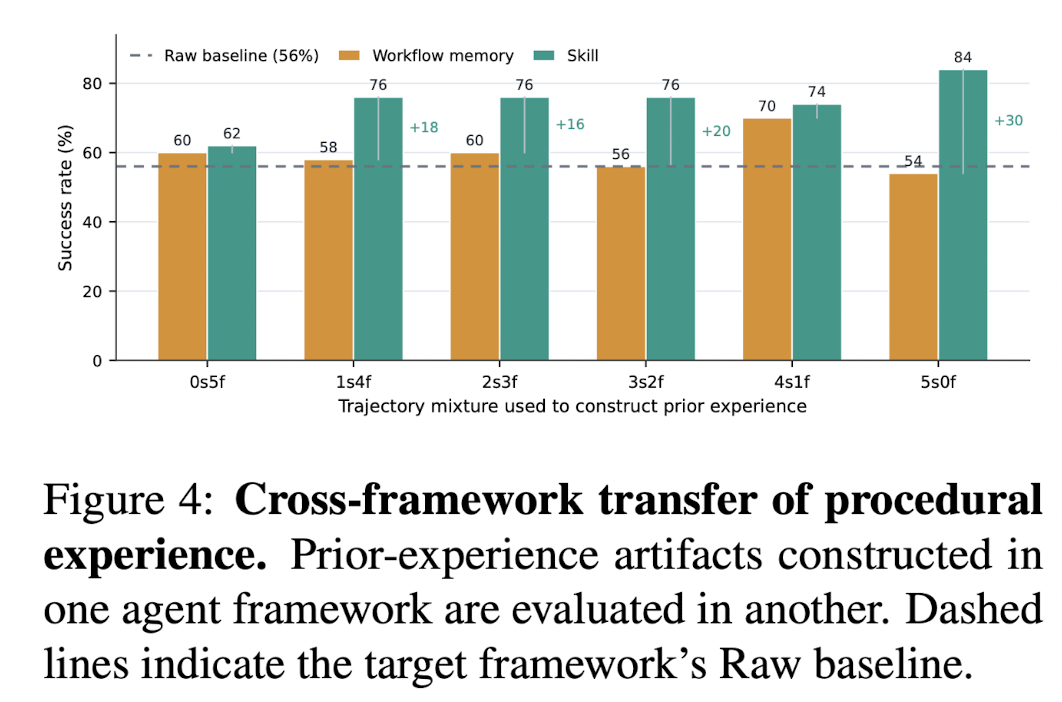
- RQ3는 Codex trajectory로 만든 artifact를 Gemini CLI에서 평가하는 식으로 cross-framework transfer를 확인합니다.
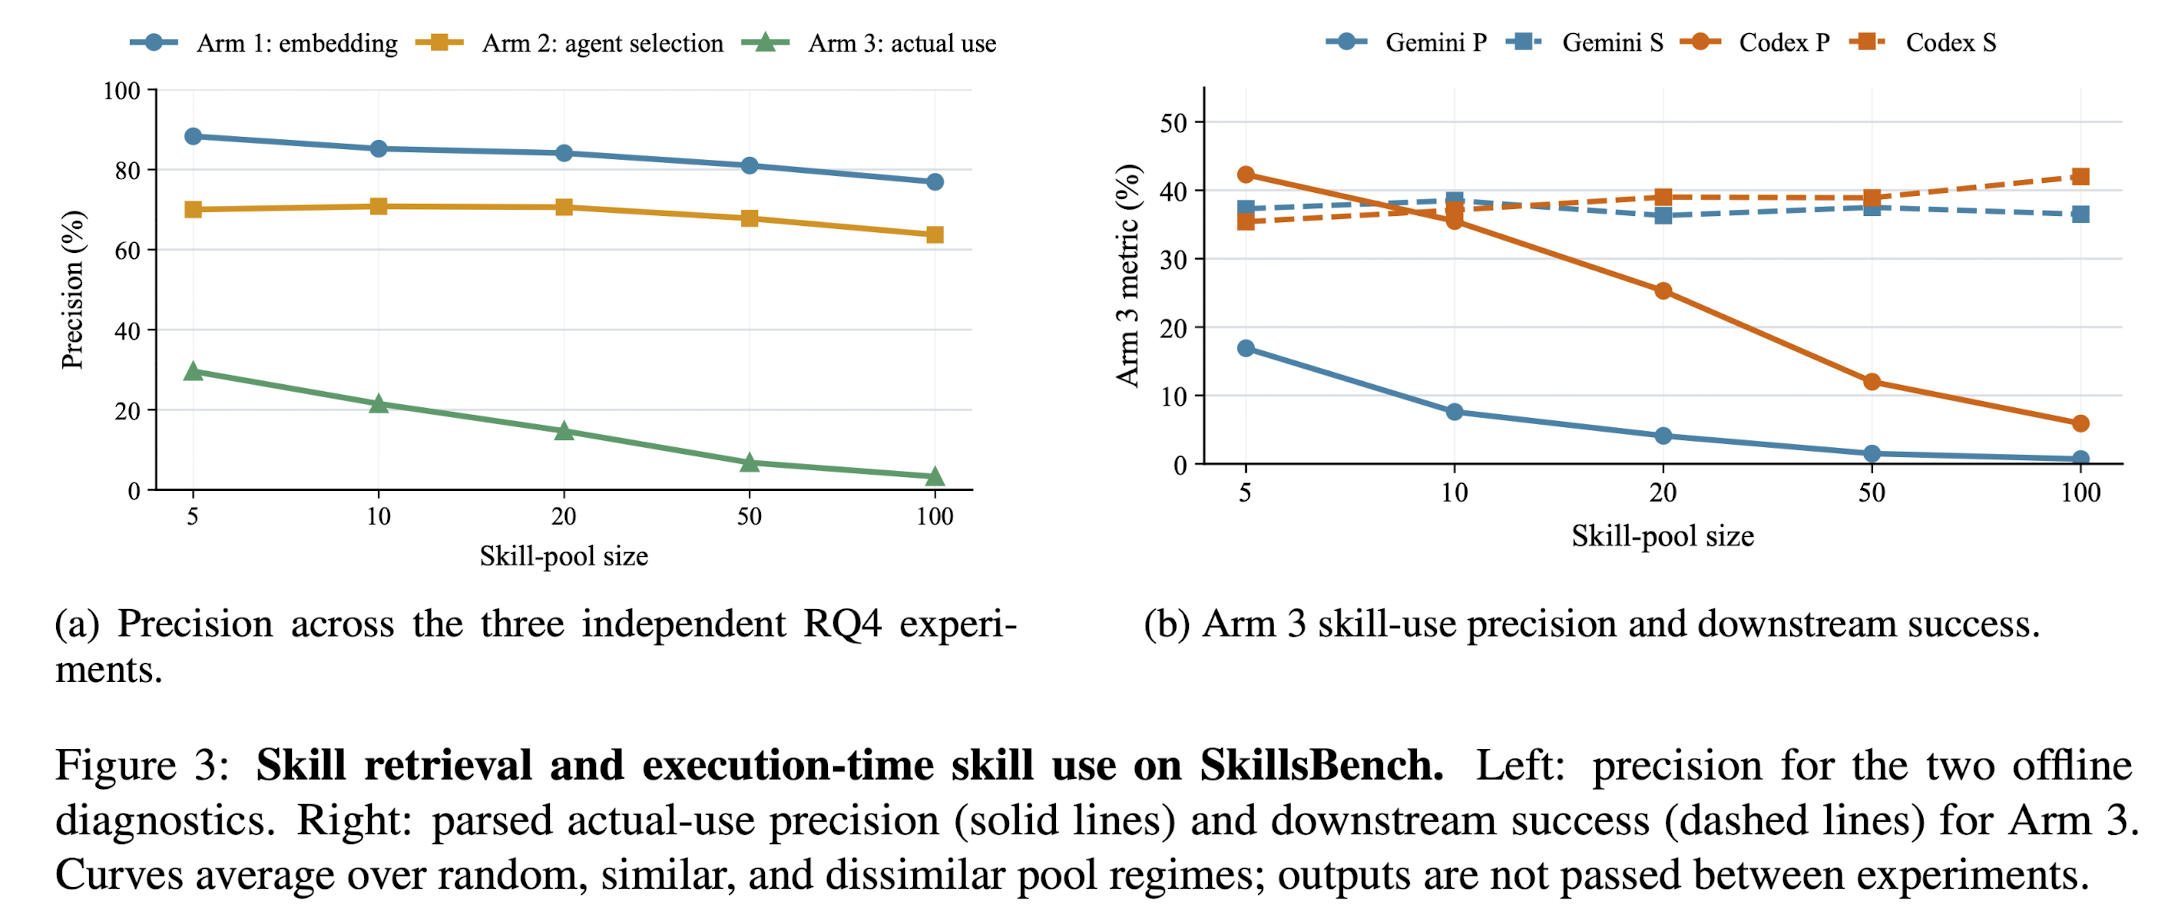
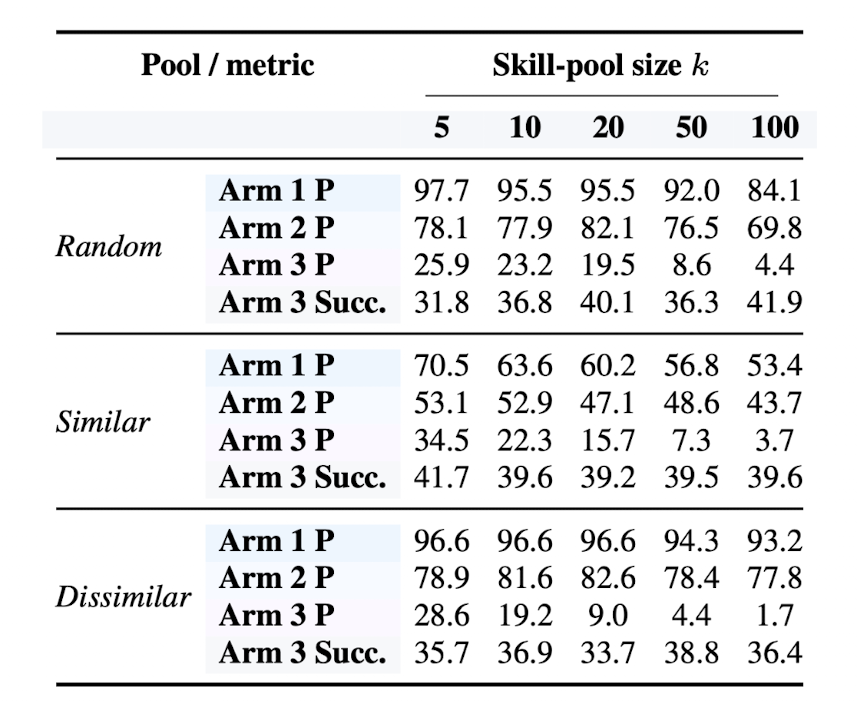
- RQ4는 SkillsBench의 task-skill annotation을 ground truth로 두고, 정답 skill에 random / similar / dissimilar distractor를 섞은 pool(크기 5~100)을 구성해서 세 가지 독립적인 실험을 돌립니다.
- (Arm 1) embedding retrieval / (Arm 2) agent가 실행 없이 skill을 고르는 explicit selection / (Arm 3) pool 전체를 환경에 넣고 실제로 태스크를 수행하는 real execution입니다.
Arm 1, 2의 결과가 Arm 3로 전달되지 않는 독립 측정이라는 점을 저자들이 여러 번 강조합니다.
2.3. Contrastive Trajectory Analysis
성공률만 보면 왜 성공했는지 알 수 없기 때문에, 저자들은 trajectory 자체를 분석하는 파이프라인을 따로 만들었습니다.
8,135개의 trial record를 정규화하고, 그중 240개를 샘플링해서 LLM(Claude Sonnet 4.6)으로 open coding을 한 뒤, 이를 12개 mode로 이루어진 taxonomy로 합칩니다.
그리고 같은 태스크에 대해 Raw / Workflow Memory / Skill 세 arm의 trajectory를 하나의 triple로 묶어(총 528개), LLM judge가 각 arm에 mode를 부여하고 skill이 어떤 mechanism으로 작동했는지(procedural_anchor / knowledge_injection / failure_warning / none / counterproductive)를 라벨링합니다.
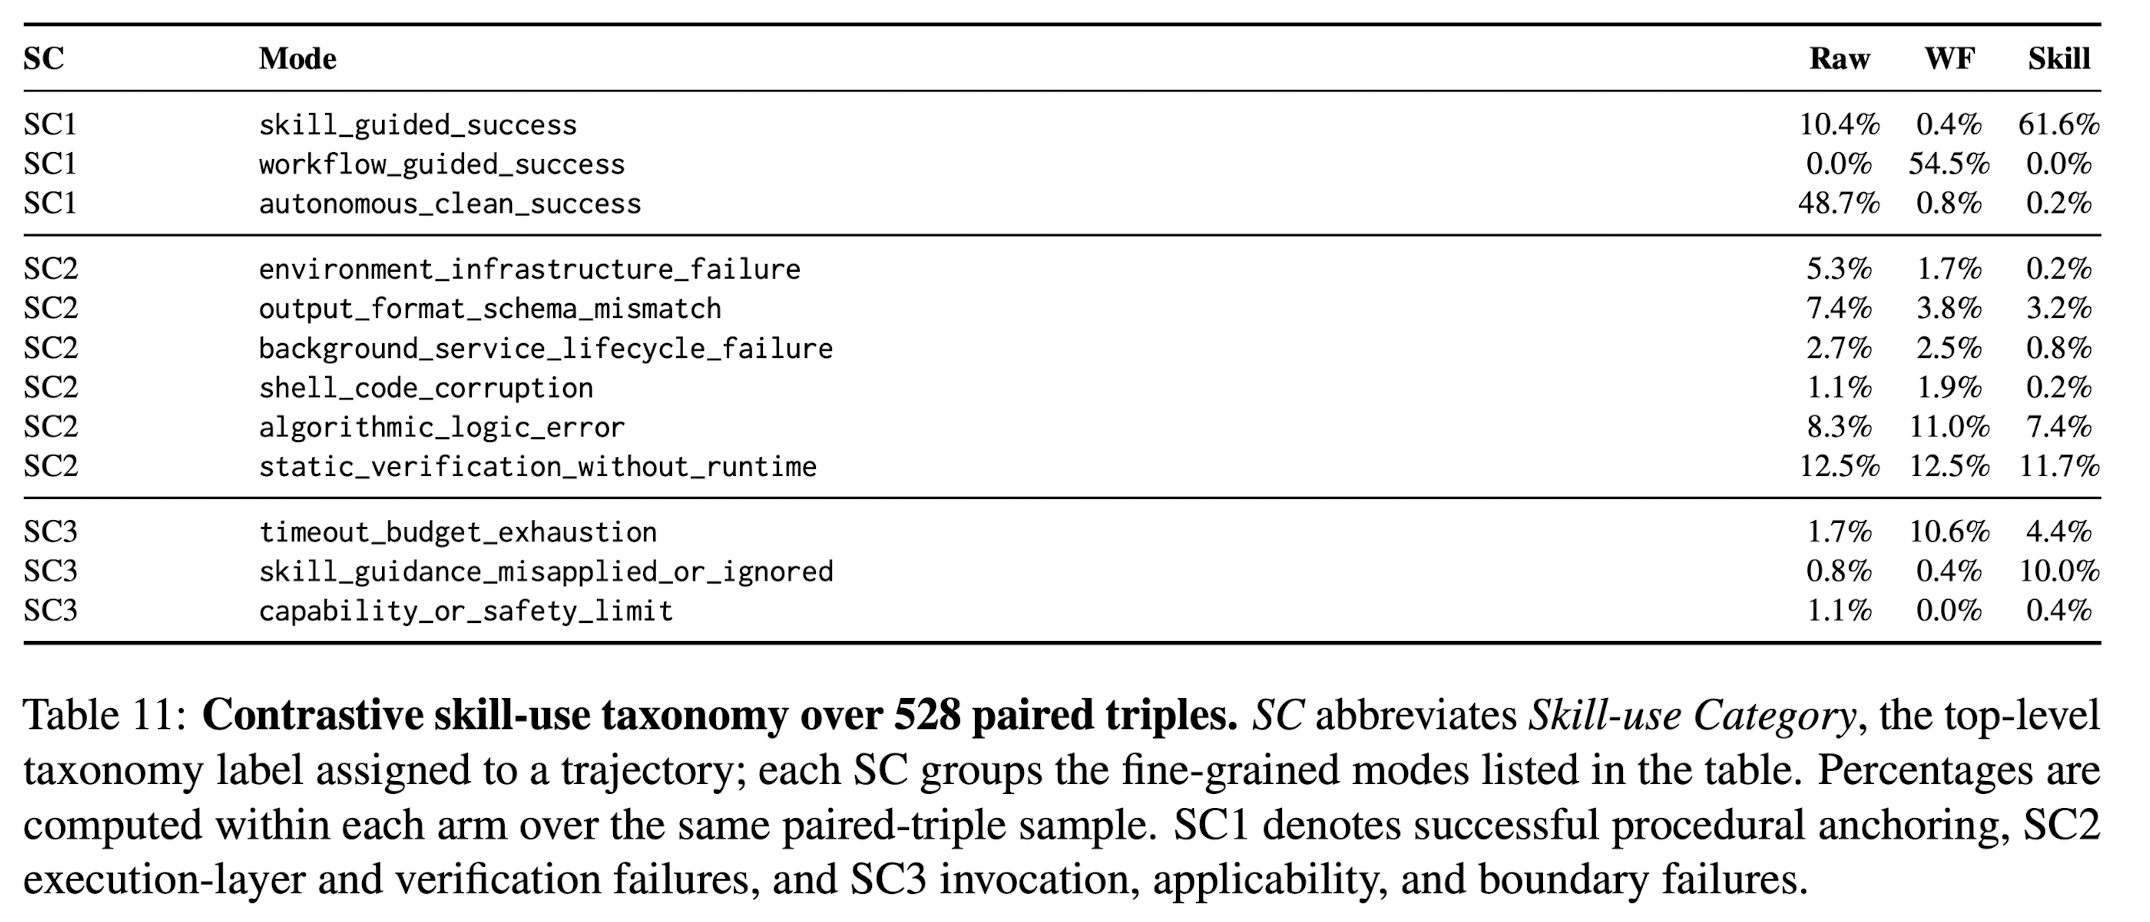
12개 mode는 세 가지 상위 카테고리로 묶입니다.
SC1 (Guided success): skill 또는 workflow의 안내를 받아 성공했거나 스스로 성공
SC2 (Execution & verification failure): 환경 세팅, output format, 서비스 관리, 알고리즘 오류, runtime 검증 없이 마무리 등 실행 단계의 실패
SC3 (Invocation & budget failure): 안내가 있었는데 잘못 적용하거나 무시, timeout, capability 한계 등
LLM 라벨링에 대한 사람의 검증도 수행했는데, taxonomy 매핑에서 95.8% exact agreement, Cohen's κ = 0.952로 꽤 안정적입니다.
LLM judge 기반 분석에 대해 늘 신뢰성 의문이 따라붙는데, 이 부분을 미리 챙긴 점은 좋았다고 생각합니다.
3. Findings
3.1. Skill은 지식이 아니라 절차를 고정한다
가장 중요한 결과입니다.
528개 triple 기준 성공률은 Skill 61.9%, Raw 59.1%, Workflow Memory 55.9%입니다.
흥미로운 건 Skill vs Raw 차이(+2.8 point)는 95% bootstrap CI가 0을 포함하는 반면, Skill vs Workflow Memory 차이(+6.06 point)는 CI [+0.76, +11.36]으로 유의미하다는 점입니다.
(Skill vs Raw 를 비교한 케이스를 무작위 추출해서 실험하는 경우, 점수 차이에 대한 신뢰 구간에 0이 포함될 수 있음, 즉 Raw가 더 우위에 있을 수도 있음을 의미합니다)
즉 이 논문의 가장 robust한 주장은 "skill이 raw보다 낫다"가 아니라 "같은 경험이라면 skill 형태가 workflow memory 형태보다 낫다"입니다.
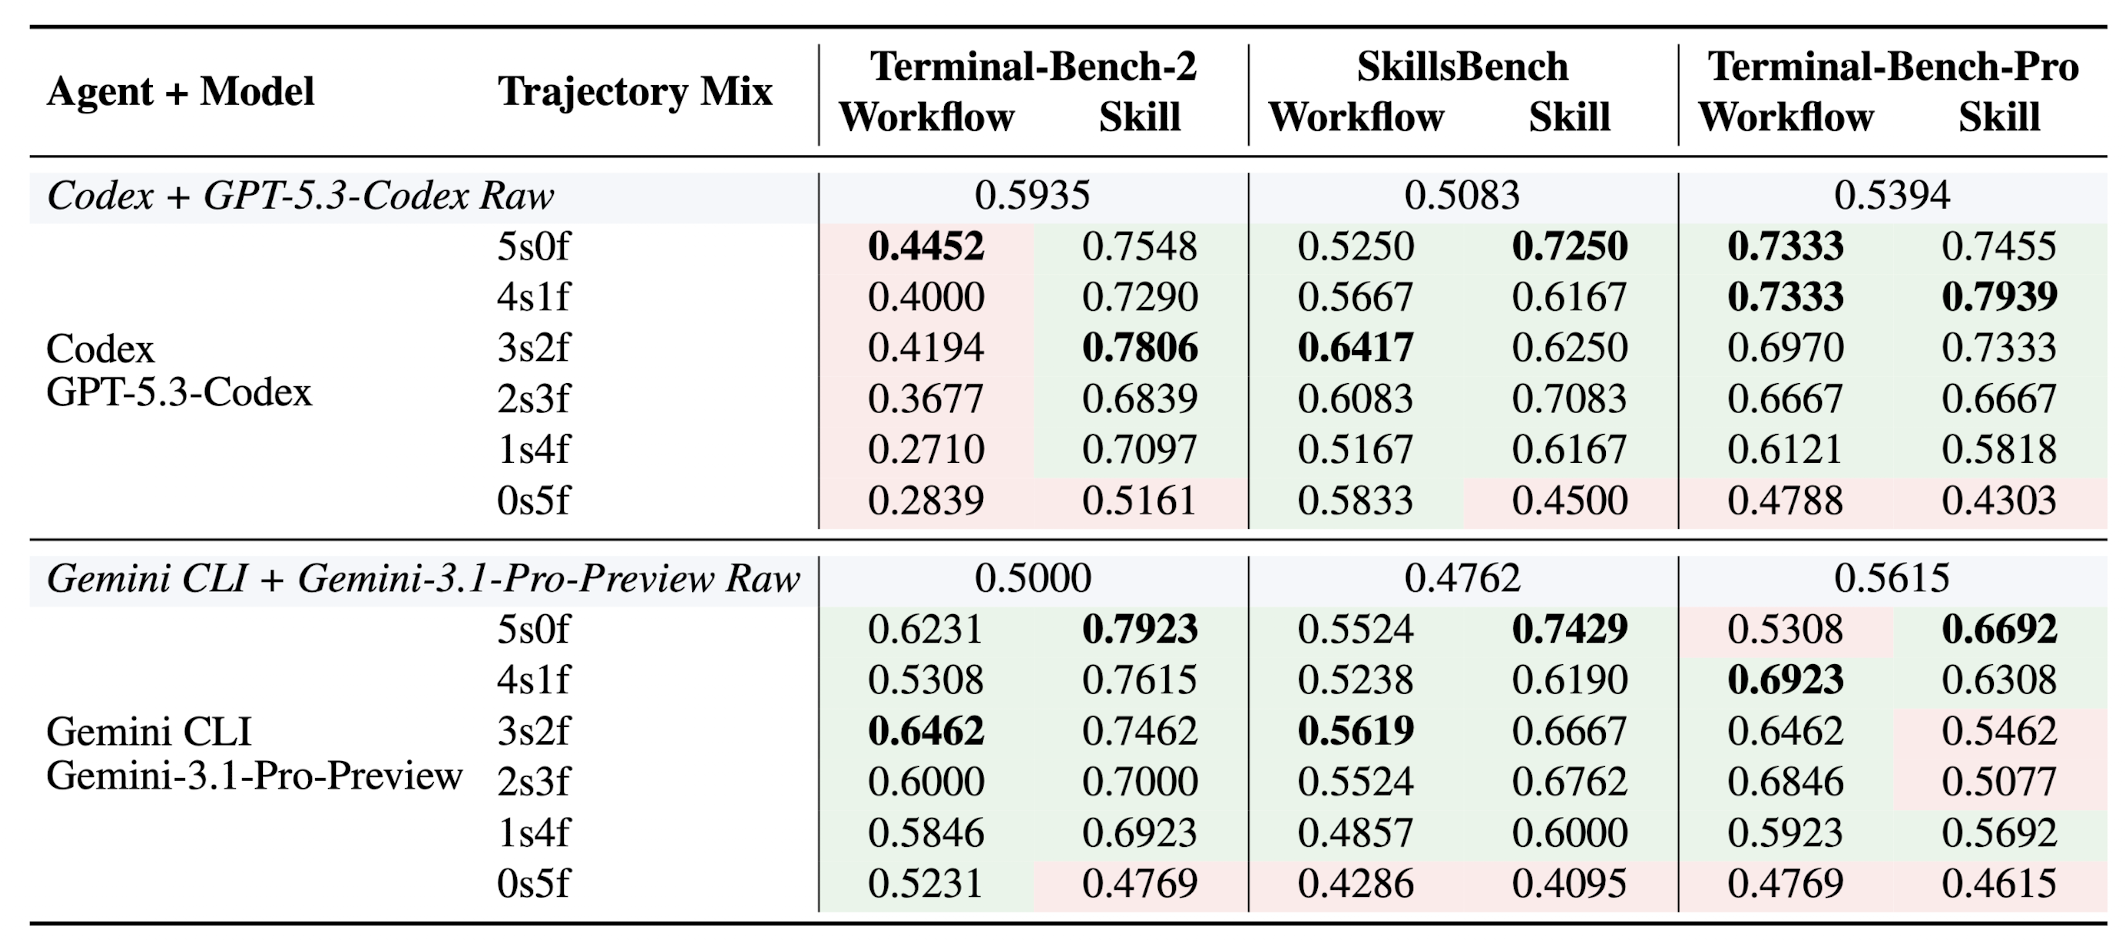
Table 1을 보면 Codex 세팅에서 workflow memory는 raw baseline(0.5935)보다 오히려 낮은 경우가 대부분인 반면, skill은 대체로 baseline을 크게 상회합니다.
Gemini에서는 workflow memory도 baseline 위에 있지만 여전히 skill이 더 높고요.
그렇다면 skill은 어떤 메커니즘으로 도움을 주는 걸까요.
mechanism label 분포를 보면 procedural_anchor가 65.7%, knowledge_injection은 4.5%에 불과합니다.
skill이 agent가 몰랐던 사실을 알려주는 게 아니라, 어떤 setup을 먼저 하고 어떤 순서로 tool을 쓰고 중간에 무엇을 확인할지를 고정시켜주는 역할을 한다는 것입니다.
부록의 paired example이 이를 잘 보여주는데요.
같은 태스크에서 Raw는 외부 API 호출을 우회해버리고, Workflow Memory는 의존적인 요청을 직렬로 남겨둬서 latency 기준을 넘기고, Skill은 "독립적인 await는 Promise.all로, 의존적인 fetch는 선행 조건이 풀리는 즉시 시작"이라는 안내를 따라 11개 테스트를 모두 통과합니다.
또한 저자들은 "그냥 짧은 절차 텍스트면 다 되는 것 아니냐"는 반론에 대비해 instruction에서 뽑은 short plan(47.7%), test-first template(59.2%) baseline도 돌렸고, 둘 다 Workflow Memory(62.3%)와 Skill(79.2%)에 못 미쳤습니다.
개인적으로 이 대조군을 넣은 게 논문의 주장을 훨씬 설득력 있게 만들었다고 생각합니다.
3.2. Skill이 잘 고치는 실패와 못 고치는 실패
taxonomy를 보면 skill이 어디에 효과적인지가 꽤 명확하게 갈립니다.
SC2(실행 단계 실패) 비중은 Raw 37.3%, Workflow 33.3%, Skill 23.5%로 확실히 줄어듭니다.
한 번 찾아낸 setup 순서나 dependency 우회법, 경로 규칙 같은 것은 절차로 굳히기 쉽기 때문에 skill의 효과가 극대화되는 영역입니다.
반면 algorithmic_logic_error(Raw 8.3% → Skill 7.4%)와 static_verification_without_runtime(12.5% → 11.7%)는 거의 그대로입니다.
문제를 다시 정의해야 하거나 실제로 코드를 돌려서 검증해야 하는 종류의 실패는 skill이 해결해주지 못한다는 뜻이죠.
당연한 얘기지만 잘못된 알고리즘을 절차 문서가 고쳐줄 수는 없으니까요.
3.3. Skill이 새로 만드는 실패
여기서부터가 제목의 "Until They Don't" 부분입니다. skill_guidance_misapplied_or_ignored mode가 Skill arm에서 10.0%로, Raw(0.8%)나 Workflow(0.4%)에 비해 크게 늘어납니다. skill이 없거나 관련 없어서가 아니라, 그럴듯한 안내가 있는데 agent가 이를 기계적으로 적용하거나 조건을 놓치거나 더 이상 성립하지 않는 가정을 그대로 가져오면서 실패하는 경우입니다. skill은 스스로 실행되는 게 아니라 agent가 "이게 지금 적용되는가, 어느 부분을 따를까, 어떻게 adapt할까, 언제 버릴까"를 판단해야 하는데, 그 판단이 새로운 failure surface가 되는 것이죠.
workflow memory는 다른 방식으로 실패합니다. timeout_budget_exhaustion이 Workflow arm에서 10.6%인데, Raw 1.7%, Skill 4.4%와 비교하면 매우 높습니다. trace를 그대로 보여주면 탐색 과정, 실패한 시도, 저수준 디버깅 경로 같은 procedural residue가 agent를 산만하게 만들어서 예산을 다 써버린다는 겁니다. skill은 증류 과정에서 이 노이즈를 제거하지만, 그 대가로 applicability 판단이라는 새로운 부담을 지운다고 정리할 수 있겠습니다.
3.4. 성공/실패 label과 cross-framework transfer
RQ2 결과는 꽤 직관적입니다.
성공 trajectory만 있는 5s0f에서는 no-hint의 영향이 거의 없지만, 실패 trajectory가 섞이기 시작하면 label을 숨겼을 때 성능이 크게 떨어집니다.
Gemini의 Terminal-Bench-2 3s2f 세팅에서는 0.7462 vs 0.4000 정도 차이가 나고요.
어떤 trajectory가 실패했는지 모르면 skill-creator가 실패한 절차를 그대로 skill에 담아버릴 수 있으니, 실패 경험을 활용하려면 outcome 정보가 필수라는 얘기입니다.
RQ3의 cross-framework transfer는 skill 쪽에 좋은 결과입니다.
Codex trajectory로 만든 artifact를 Gemini CLI에서 평가했을 때, workflow memory는 raw baseline(56%) 근처에 머무는 반면 skill은 62~84%로 최대 +30 point까지 올라갑니다.
trace-level 디테일은 원래 프레임워크의 tool interface나 prompting 스타일에 묶여 있지만, 절차로 추상화한 skill은 그 결합이 풀린다고 볼 수 있겠습니다.
3.5. Retrieval을 잘해도 성공을 보장하지 않는다
개인적으로 가장 흥미로웠던 부분입니다.
먼저 offline diagnostic(Arm 1, 2)을 보면 pool이 5 → 100으로 커질 때 embedding top-1 precision은 88.3% → 76.9%, agent explicit selection은 70.0% → 63.7%로 완만하게 떨어집니다.
그런데 distractor 종류로 쪼개보면 similar pool에서만 크게 무너집니다.
Arm 1 기준 random pool은 97.7% → 84.1%인데 similar pool은 70.5% → 53.4%이고, Arm 2도 마찬가지로 similar에서 절반 근처까지 내려가요.
pool 크기 자체보다 의미적으로 비슷한 skill이 섞여 있는 것이 훨씬 큰 스트레스 요인이라는 뜻입니다.
그런데 실제 실행(Arm 3)에서는 전혀 다른 그림이 나옵니다.
agent가 실제로 열어보거나 호출한 skill의 precision은 pool이 커지면서 29.6% → 3.3%로 폭락하는데, downstream 성공률은 36.4% → 39.3%로 거의 그대로입니다.
Codex는 오히려 성공률이 올라가기도 하고요.
반면 recall은 k = 100에서도 54~74%로 꽤 높습니다.
즉 agent는 정답 skill을 아예 못 찾는 게 아니라, 정답과 함께 여러 distractor를 같이 뒤적이는 방식으로 행동하고, 그렇게 해도 태스크 성공에는 별 영향이 없다는 것이죠.
저자들은 이를 "정답 skill 호출은 성공의 충분조건도 필요조건도 아니다"라고 정리합니다.
정답 skill을 골랐어도 잘못된 맥락에 적용하거나 피상적으로만 호출하거나 timeout, numerical precision, missing dependency 같은 태스크 자체의 병목에 막히면 실패하고, 반대로 정답이 아닌 유사 skill도 부분적인 절차 지원을 제공할 수 있기 때문입니다.
그래서 retrieval accuracy와 task success는 하나의 파이프라인의 연속된 단계가 아니라 skill use의 서로 다른 측면을 측정하는 독립적인 지표로 봐야 한다는 게 결론입니다.
다만 여기서 조금 짚고 싶은 건, Arm 3의 precision이 trajectory에서 파싱한 "접근한 skill" 기준이라는 점입니다.
agent가 skill 여러 개를 훑어보는 것 자체가 나쁜 행동인지는 좀 애매한 것 같아요.
사람도 문서 여러 개를 열어보고 필요한 것만 쓰니까요.
precision 폭락을 "retrieval 실패"로 읽기보다는 "정답 skill 하나만 쓰도록 강제하는 것이 애초에 의미가 없다"는 근거로 읽는 게 더 맞지 않나 싶습니다.
4. Conclusion and Discussion
저자들은 skill use를 단일한 memory injection이 아니라 lifecycle 문제로 봐야 한다고 결론 내립니다.
경험이 적절한 추상화 수준으로 증류되고, 호환되는 맥락으로 retrieval 또는 transfer되고, agent가 이를 호출하고, 실행 중에 adapt하는 각 단계에서 skill은 도움이 될 수도 있고 실패할 수도 있다는 겁니다.
이 논문에서 제가 얻어간 포인트를 정리하자면 다음과 같습니다.
skill은 지식이 아니라 절차를 주는 것이라서, 환경 세팅이나 output format처럼 "한 번 알아내면 반복되는" 실패에 특히 효과적이고, 알고리즘 오류나 검증 부족처럼 사고력이 필요한 실패에는 무력합니다.
workflow memory와의 차이는 결국 노이즈 제거인데, 노이즈를 제거하면 timeout은 줄지만 대신 "이 skill을 지금 써야 하나"라는 판단 실패가 새로 생깁니다.
그리고 skill이 많아질수록 정답 하나를 콕 집어내는 능력은 떨어지지만, 그게 곧 태스크 실패로 이어지지는 않습니다.
실무적으로 시사하는 바도 꽤 있다고 생각하는데요.
skill을 만들 때 실패 trajectory를 활용하려면 반드시 outcome label을 같이 줘야 하고(no-hint 결과), skill을 다른 agent 프레임워크로 옮기는 건 생각보다 잘 되며(RQ3), skill library가 커지는 것 자체를 너무 두려워할 필요는 없다는 것(RQ4) 정도가 되겠습니다.
반대로 skill 개수를 늘리는 것보다 agent가 skill을 "언제 안 써야 하는지" 판단하게 만드는 쪽이 더 중요한 다음 단계일 것 같습니다.
아쉬운 점도 있습니다.
RQ4에서 Codex 쪽 모델이 GPT-5.3-Codex에서 GPT-5.4로 바뀌어서 RQ1~3과 직접 비교가 안 되고, taxonomy가 전체 record의 약 3%에 대한 open coding에서 유도된 것이라 드문 failure mode는 빠져 있을 수 있습니다.
또 terminal/tool-use 벤치마크에 한정되어 있어서, long-horizon web interaction이나 open-ended 협업 같은 세팅에서도 procedural anchoring이 지배적인 메커니즘일지는 별도로 확인이 필요해 보입니다.
(저자들이 스스로 밝힌 한계점들입니다)
skill-creator 프롬프트가 하나로 고정되어 있다는 점도 신경 쓰이는데, 증류 방식이 달라지면 skill의 추상화 수준이 달라지고 그에 따라 misapplied 비율도 꽤 움직이지 않을까 싶네요.
그래도 "skill이 좋다"에서 멈추지 않고 "왜 좋고 언제 나쁜지"를 mechanism 수준으로 분해한 것 자체가 의미 있는 시도였다고 생각합니다.
앞으로는 skill을 자동으로 생성하고 진화시키는 연구들이 이런 taxonomy를 평가 지표로 활용하는 방향으로 이어지지 않을까 기대해봅니다.